Introducción
Guía Data Science - Python para Data Science: Python se ha consolidado como uno de los lenguajes de referencia para la ciencia de datos gracias a un ecosistema de librerías que cubre prácticamente todas las etapas del trabajo analítico: cálculo numérico, preparación de información, visualización, estadística, aprendizaje automático y procesamiento distribuido. La encuesta de Stack Overflow de 2025 registró un incremento de siete puntos porcentuales en su utilización respecto al año anterior, asociado a su relevancia en inteligencia artificial, Data Science y desarrollo de software. (Stack Overflow, 2025)
Sin embargo, conocer Python no equivale a dominar su ecosistema. Cada librería responde a necesidades concretas y la elección condiciona el rendimiento, reproducibilidad y calidad de un proyecto. La mejor competencia profesional consiste en seleccionar y combinar herramientas según el problema, no en acumular paquetes sin metodología.
1-NumPy: cálculo numérico y operaciones con arrays
NumPy constituye una base matemática del ecosistema científico de Python. Su estructura principal, el ndarray, representa matrices y arrays multidimensionales sobre los que se ejecutan operaciones numéricas vectorizadas, álgebra lineal, simulaciones y cálculos estadísticos. La documentación oficial de NumPy 2.5 recoge estas capacidades como parte de su núcleo funcional. (NumPy, 2026)
¿Para qué sirve?
NumPy resulta útil cuando se necesita manipular grandes conjuntos de valores numéricos, realizar operaciones matriciales o preparar datos para algoritmos estadísticos y modelos de aprendizaje automático.
La importancia también es arquitectónica, numerosas librerías se apoyan en sus estructuras numéricas. Comprender arrays, dimensiones, tipos de datos y vectorización facilita trabajar posteriormente con herramientas más especializadas.
2-pandas: transformación y análisis de datos tabulares
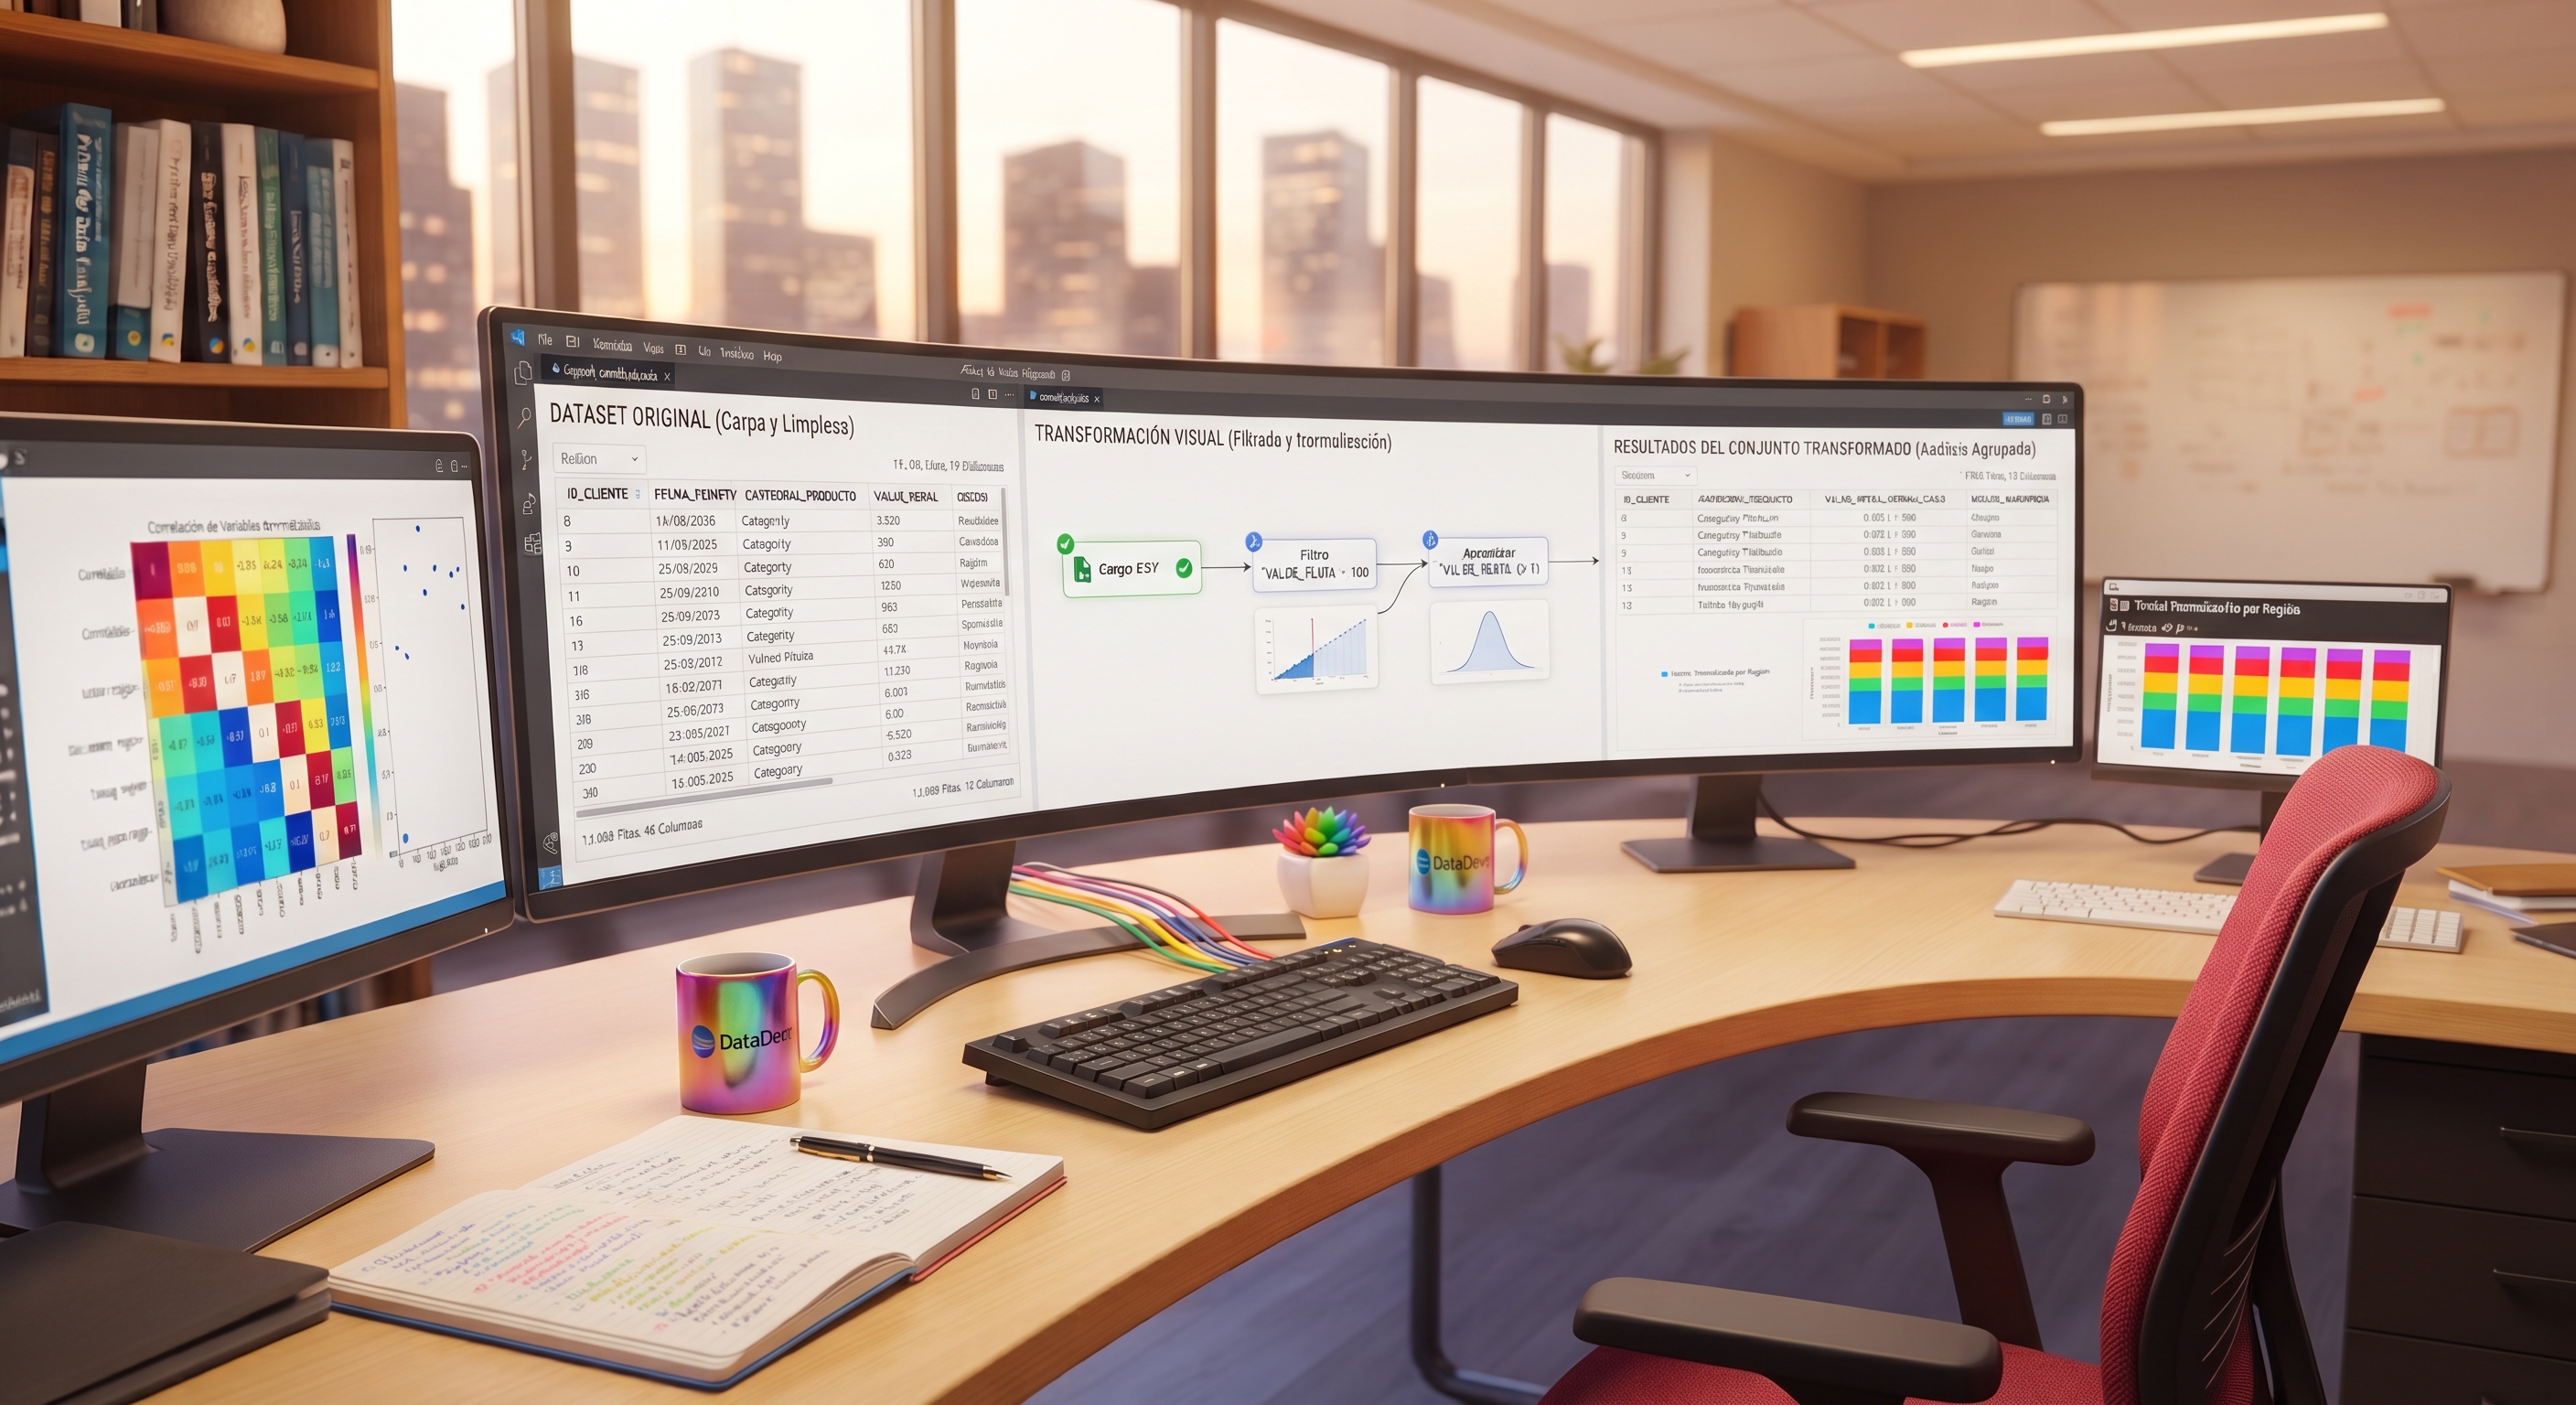
pandas es una de las librerías más importantes para el análisis cotidiano. Sus estructuras Series y DataFrame permiten organizar información en filas y columnas, importar archivos CSV, Excel, JSON o Parquet y consultar datos procedentes de bases SQL. La documentación oficial describe las funcionalidades para limpieza, transformación, agregación y análisis de series temporales. (pandas, 2026)
¿Para qué sirve?
Se utiliza para seleccionar observaciones, corregir formatos, gestionar valores ausentes, eliminar duplicados, combinar tablas, agrupar registros y generar estadísticas descriptivas.
En un análisis comercial, por ejemplo, pandas facilita integrar ventas y clientes, calcular ingresos por categoría y estudiar la evolución mensual. La ventaja reside en reunir numerosas operaciones dentro de un flujo programable y reproducible.
Este apartado amplía el recorrido presentado en el artículo Python para análisis de datos: por dónde empezar, allí la atención se centra en el itinerario de aprendizaje, pero aquí distinguimos las funciones específicas de las librerías que forman el entorno analítico.
Polars: una alternativa para procesamiento tabular
Polars ofrece otra aproximación al trabajo con tablas. Su API lazy permite definir transformaciones antes de ejecutarlas y aplicar optimizaciones sobre el conjunto de operaciones. También incorpora ejecución paralela y procesamiento por flujos para determinadas cargas. (Polars, 2026)
Claro, no sustituye automáticamente a pandas. La elección depende del volumen, la memoria disponible, las operaciones requeridas, compatibilidad con el resto del proyecto y rendimiento medido en condiciones reales.
3-SciPy: algoritmos científicos y matemáticos
SciPy amplía las capacidades numéricas de NumPy mediante algoritmos especializados. Incluye herramientas para optimización, integración, interpolación, estadística, resolución de ecuaciones, álgebra lineal y análisis de señales. La versión 1.18.1 se publicó en agosto de 2026. (SciPy, 2026)
La utilidad aparece cuando el análisis exige métodos matemáticos más avanzados que operaciones elementales. Entre sus aplicaciones figuran la optimización de parámetros, el tratamiento de señales y determinados cálculos científicos.
En Data Science, SciPy ayuda a conectar el procesamiento numérico con métodos estadísticos y computacionales especializados.
4-Matplotlib, Seaborn y Plotly: visualización de datos
La visualización no se limita a presentar resultados. También sirve para detectar anomalías, explorar distribuciones y examinar relaciones entre variables.
Matplotlib proporciona una base flexible para crear gráficos estáticos, animados e interactivos. Seaborn construye sobre Matplotlib y ofrece una interfaz orientada a visualización estadística, integrada con pandas y NumPy. (Matplotlib, 2026, Seaborn, s. f.)
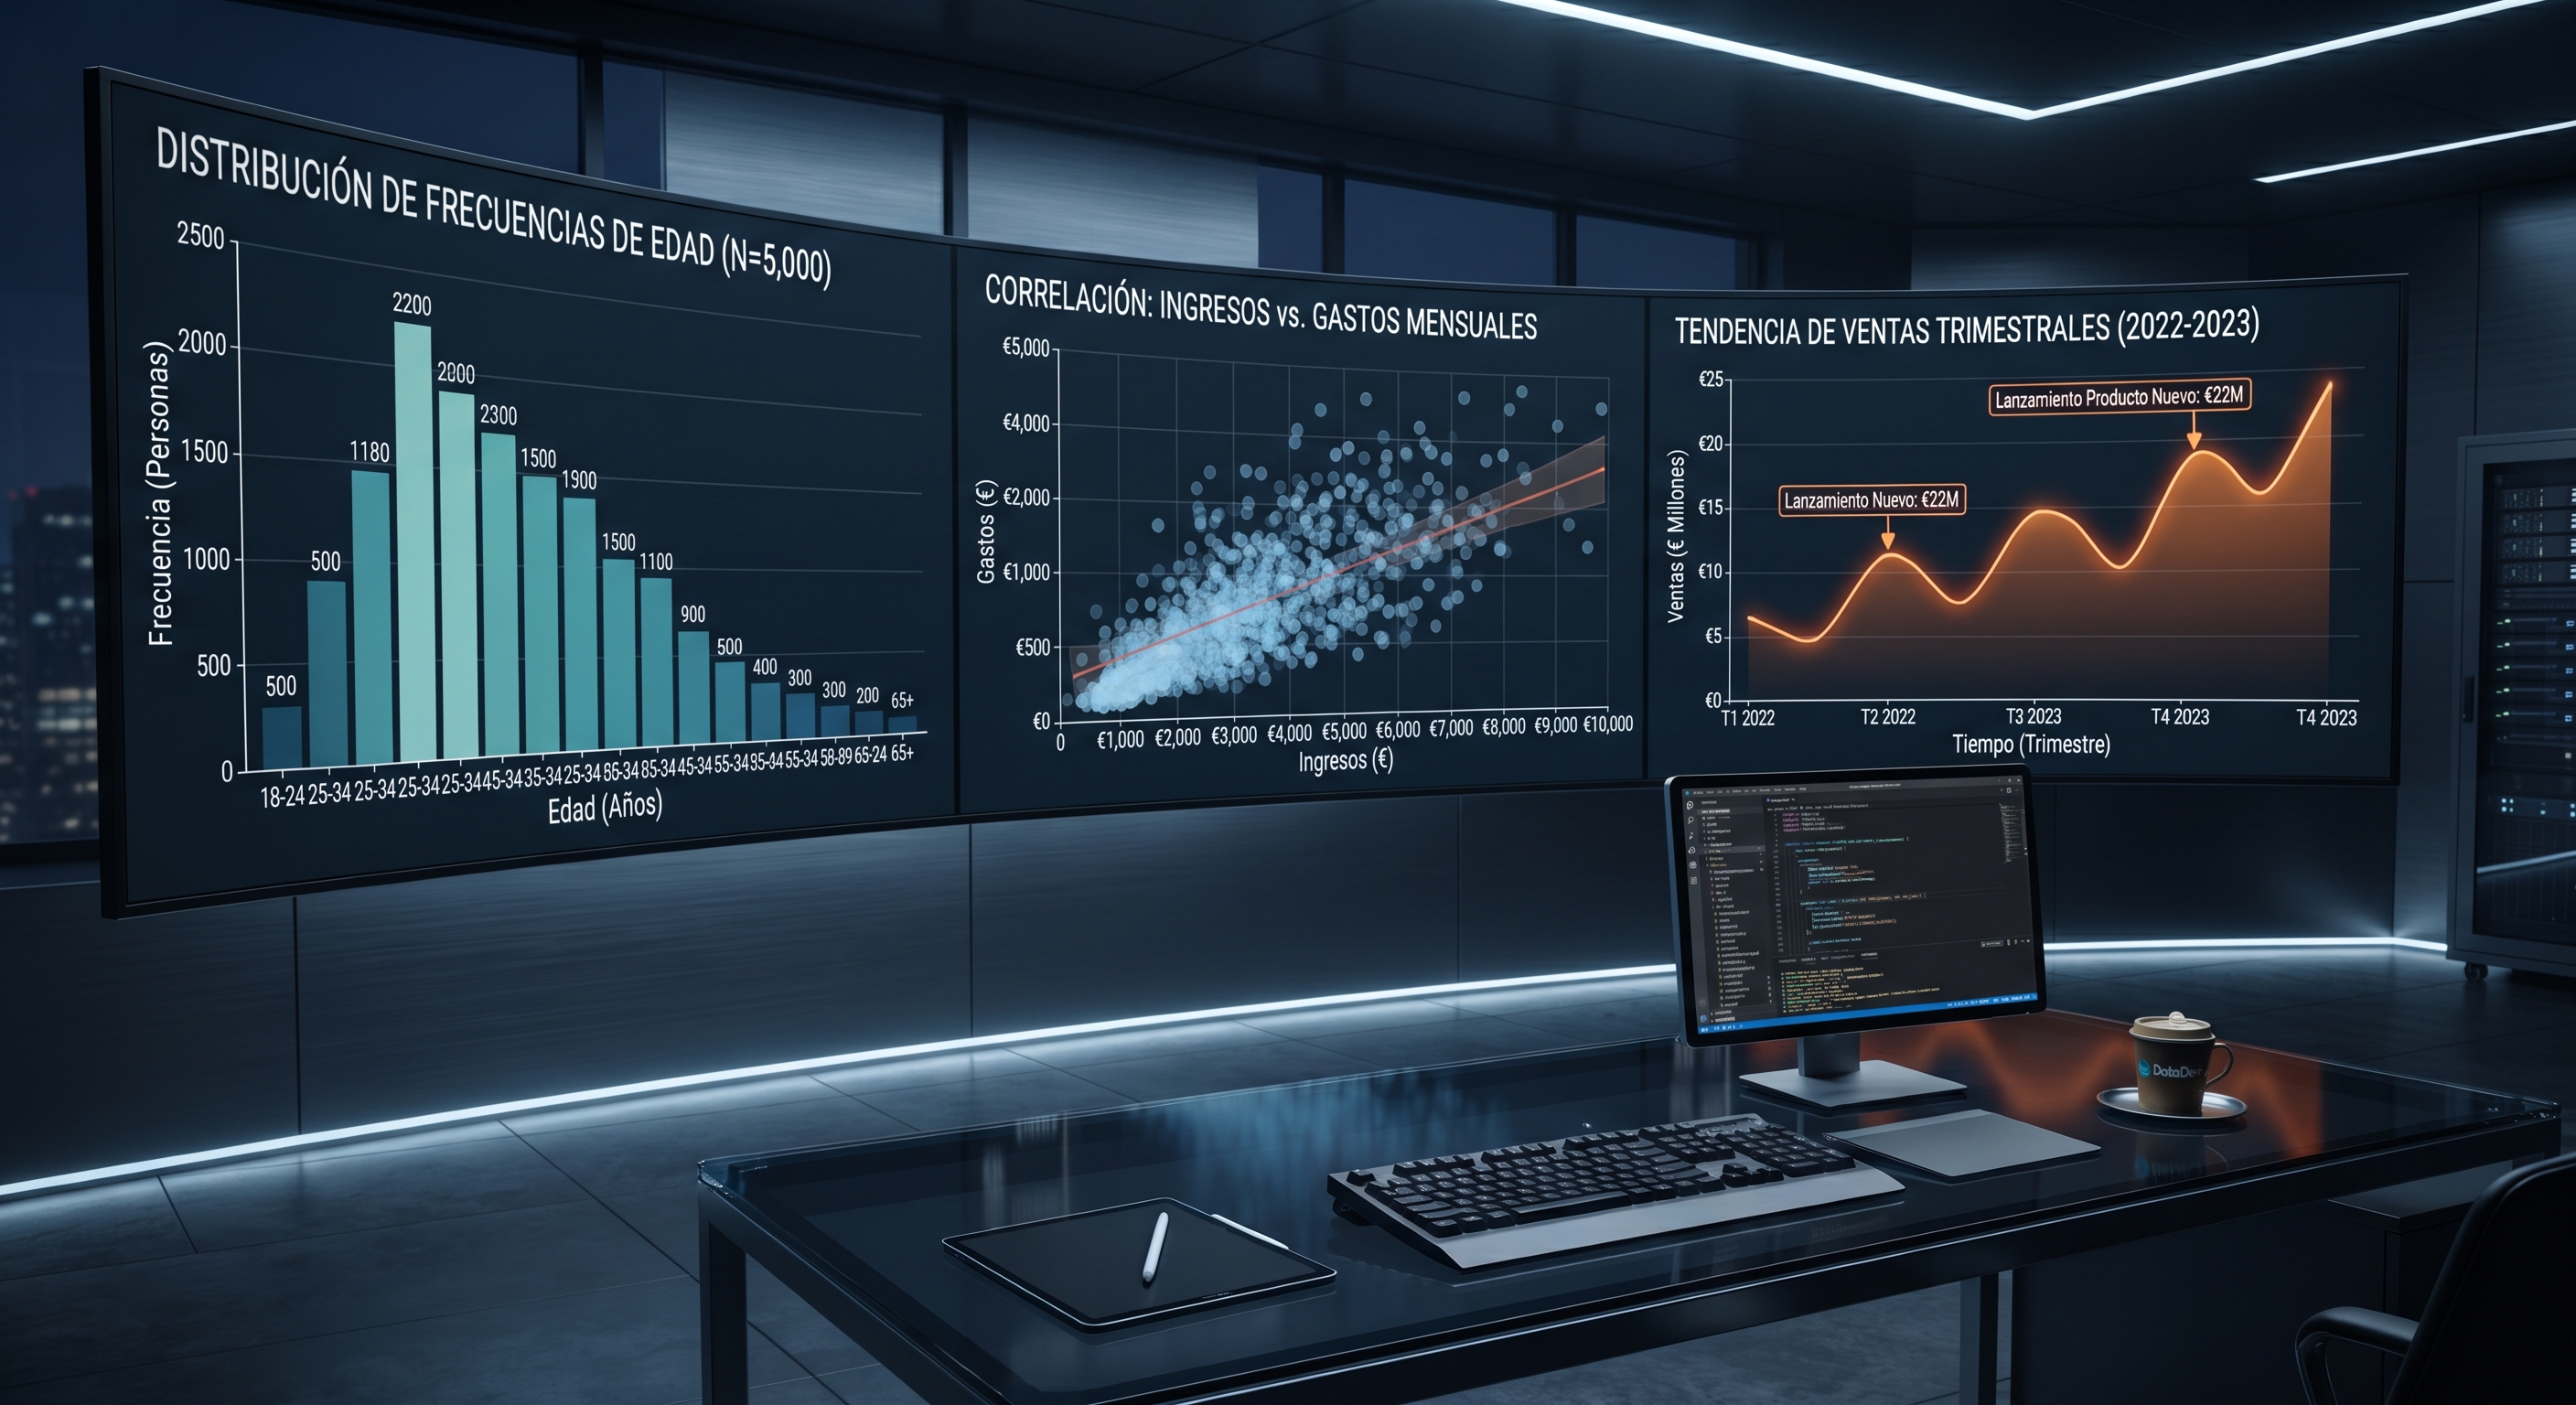
Plotly, por su parte, está especialmente orientada a gráficos interactivos, mapas y visualizaciones que se integran en aplicaciones web. (Plotly, 2026)
¿Cuál conviene utilizar?
Matplotlib resulta adecuado cuando se necesita controlar detalladamente la representación. Seaborn facilita el análisis exploratorio estadístico. Y Plotly destaca cuando la interacción del usuario aporta valor.
La decisión debe responder a la finalidad del gráfico. Una representación visualmente atractiva no garantiza una interpretación correcta (escalas, categorías, unidades y agregaciones siguen siendo decisiones analíticas).
5-statsmodels: inferencia y modelización estadística
Mientras las bibliotecas de visualización ayudan a explorar patrones, statsmodels se orienta a la estimación y evaluación de modelos estadísticos. Su catálogo incluye regresión lineal y generalizada, modelos mixtos, análisis de varianza, métodos de series temporales y herramientas de inferencia. (statsmodels, 2026)
¿Para qué sirve?
Es especialmente útil cuando el objetivo no se limita a predecir, sino que también busca estimar relaciones, contrastar hipótesis, examinar coeficientes y cuantificar incertidumbre.
Por ejemplo, un analista económico que estudia cómo se relacionan el gasto y los ingresos necesitará tanto estimar el modelo como examinar sus supuestos e interpretar sus resultados.
Este enfoque también complementa el artículo R para análisis de datos: guía para principiantes: Python y R mantienen ecosistemas diferentes, pero ambos permiten desarrollar análisis estadísticos rigurosos. La elección entre ellos depende del método, las herramientas disponibles y las necesidades del proyecto.
6-Scikit-learn: Machine Learning convencional
Scikit-learn proporciona herramientas para aprendizaje supervisado y no supervisado, preprocesamiento, selección de variables, validación, evaluación y ajuste de hiperparámetros. Se apoya en NumPy, SciPy y Matplotlib, lo que facilita integrarlo en el flujo general de análisis. La versión estable consultada es la 1.9.1, publicada en septiembre de 2026. (scikit-learn, 2026)
¿Para qué sirve?
Su repertorio incluye regresión, clasificación, árboles de decisión, Random Forest, clustering, reducción de dimensionalidad y otras familias de algoritmos. Una aplicación típica consiste en preparar un dataset, separar los datos de entrenamiento y prueba, ajustar modelos y comparar sus resultados mediante métricas apropiadas.
Este bloque enlaza con Principales algoritmos de Machine Learning y para qué sirve cada uno: conocer las funciones de scikit-learn es la dimensión instrumental; saber escoger un algoritmo, evaluar errores y justificar su utilización es la dimensión metodológica.
En el ámbito del Máster en Big Data y Data Science de la UNED, esta distinción resulta relevante para relacionar la implementación informática con la validación de modelos y la interpretación de resultados. El programa incluye contenidos de minería de datos, evaluación predictiva y técnicas de aprendizaje automático. (UNED, s. f.)
XGBoost: gradient boosting de alto rendimiento
XGBoost está especializado en árboles potenciados mediante gradient boosting y se utiliza ampliamente en tareas tabulares de clasificación y regresión. Añade una alternativa a los modelos que ofrece scikit-learn cuando el rendimiento predictivo y el ajuste de hiperparámetros son prioritarios.
Su presencia en un proyecto no garantiza mejores resultados, la comparación debe realizarse mediante validación, control del sobreajuste y métricas vinculadas al objetivo real.
7-PyTorch y TensorFlow: Deep Learning
Cuando el problema requiere redes neuronales profundas, dos herramientas destacadas son PyTorch y TensorFlow.
PyTorch ofrece tensores, cálculo mediante GPU y componentes para construir y entrenar redes neuronales. (PyTorch, 2026) TensorFlow proporciona un entorno integral para cálculo numérico, diferenciación automática, entrenamiento, exportación y ejecución de modelos, tanto en dispositivos locales como en infraestructuras distribuidas. (TensorFlow, s. f.)
Se utilizan en visión artificial, procesamiento del lenguaje natural, audio, predicción secuencial y sistemas generativos. Su elección depende de las arquitecturas necesarias, el entorno de despliegue, la compatibilidad tecnológica y las competencias del equipo.
Recordemos en esto el artículo Deep Learning aplicado a imágenes y lenguaje, donde se explican las arquitecturas y sus aplicaciones. Aquí el foco recae en las bibliotecas que permiten implementarlas. El Máster en Big Data y Data Science de la UNED incorpora redes neuronales, CNN, RNN, Transformers y herramientas de aprendizaje profundo dentro de sus contenidos avanzados.
Hugging Face Transformers: modelos preentrenados y multimodales
La biblioteca transformers facilita utilizar modelos preentrenados para tareas de texto, visión, audio, vídeo y procesamiento multimodal. La documentación incluye herramientas para inferencia, entrenamiento, generación y ajuste de modelos. La versión estable consultada es la 5.19.0. (Hugging Face, 2026)
La principal ventaja es reducir el trabajo necesario para comenzar con arquitecturas ya entrenadas. No elimina, sin embargo, la necesidad de evaluar el sesgo, los datos de entrada, los errores y las limitaciones del modelo.
8-PySpark: análisis distribuido y Big Data
Las librerías anteriores cubren buena parte del análisis en entornos locales. Cuando el volumen de datos o los requisitos operativos exigen distribución entre nodos, PySpark permite utilizar Python sobre Apache Spark.
PySpark incorpora Spark SQL, DataFrames, procesamiento de flujos y herramientas de Machine Learning en entornos distribuidos. La documentación de la versión 4.2.0 destaca su utilidad para el procesamiento y análisis a gran escala. (Apache Spark, 2026)
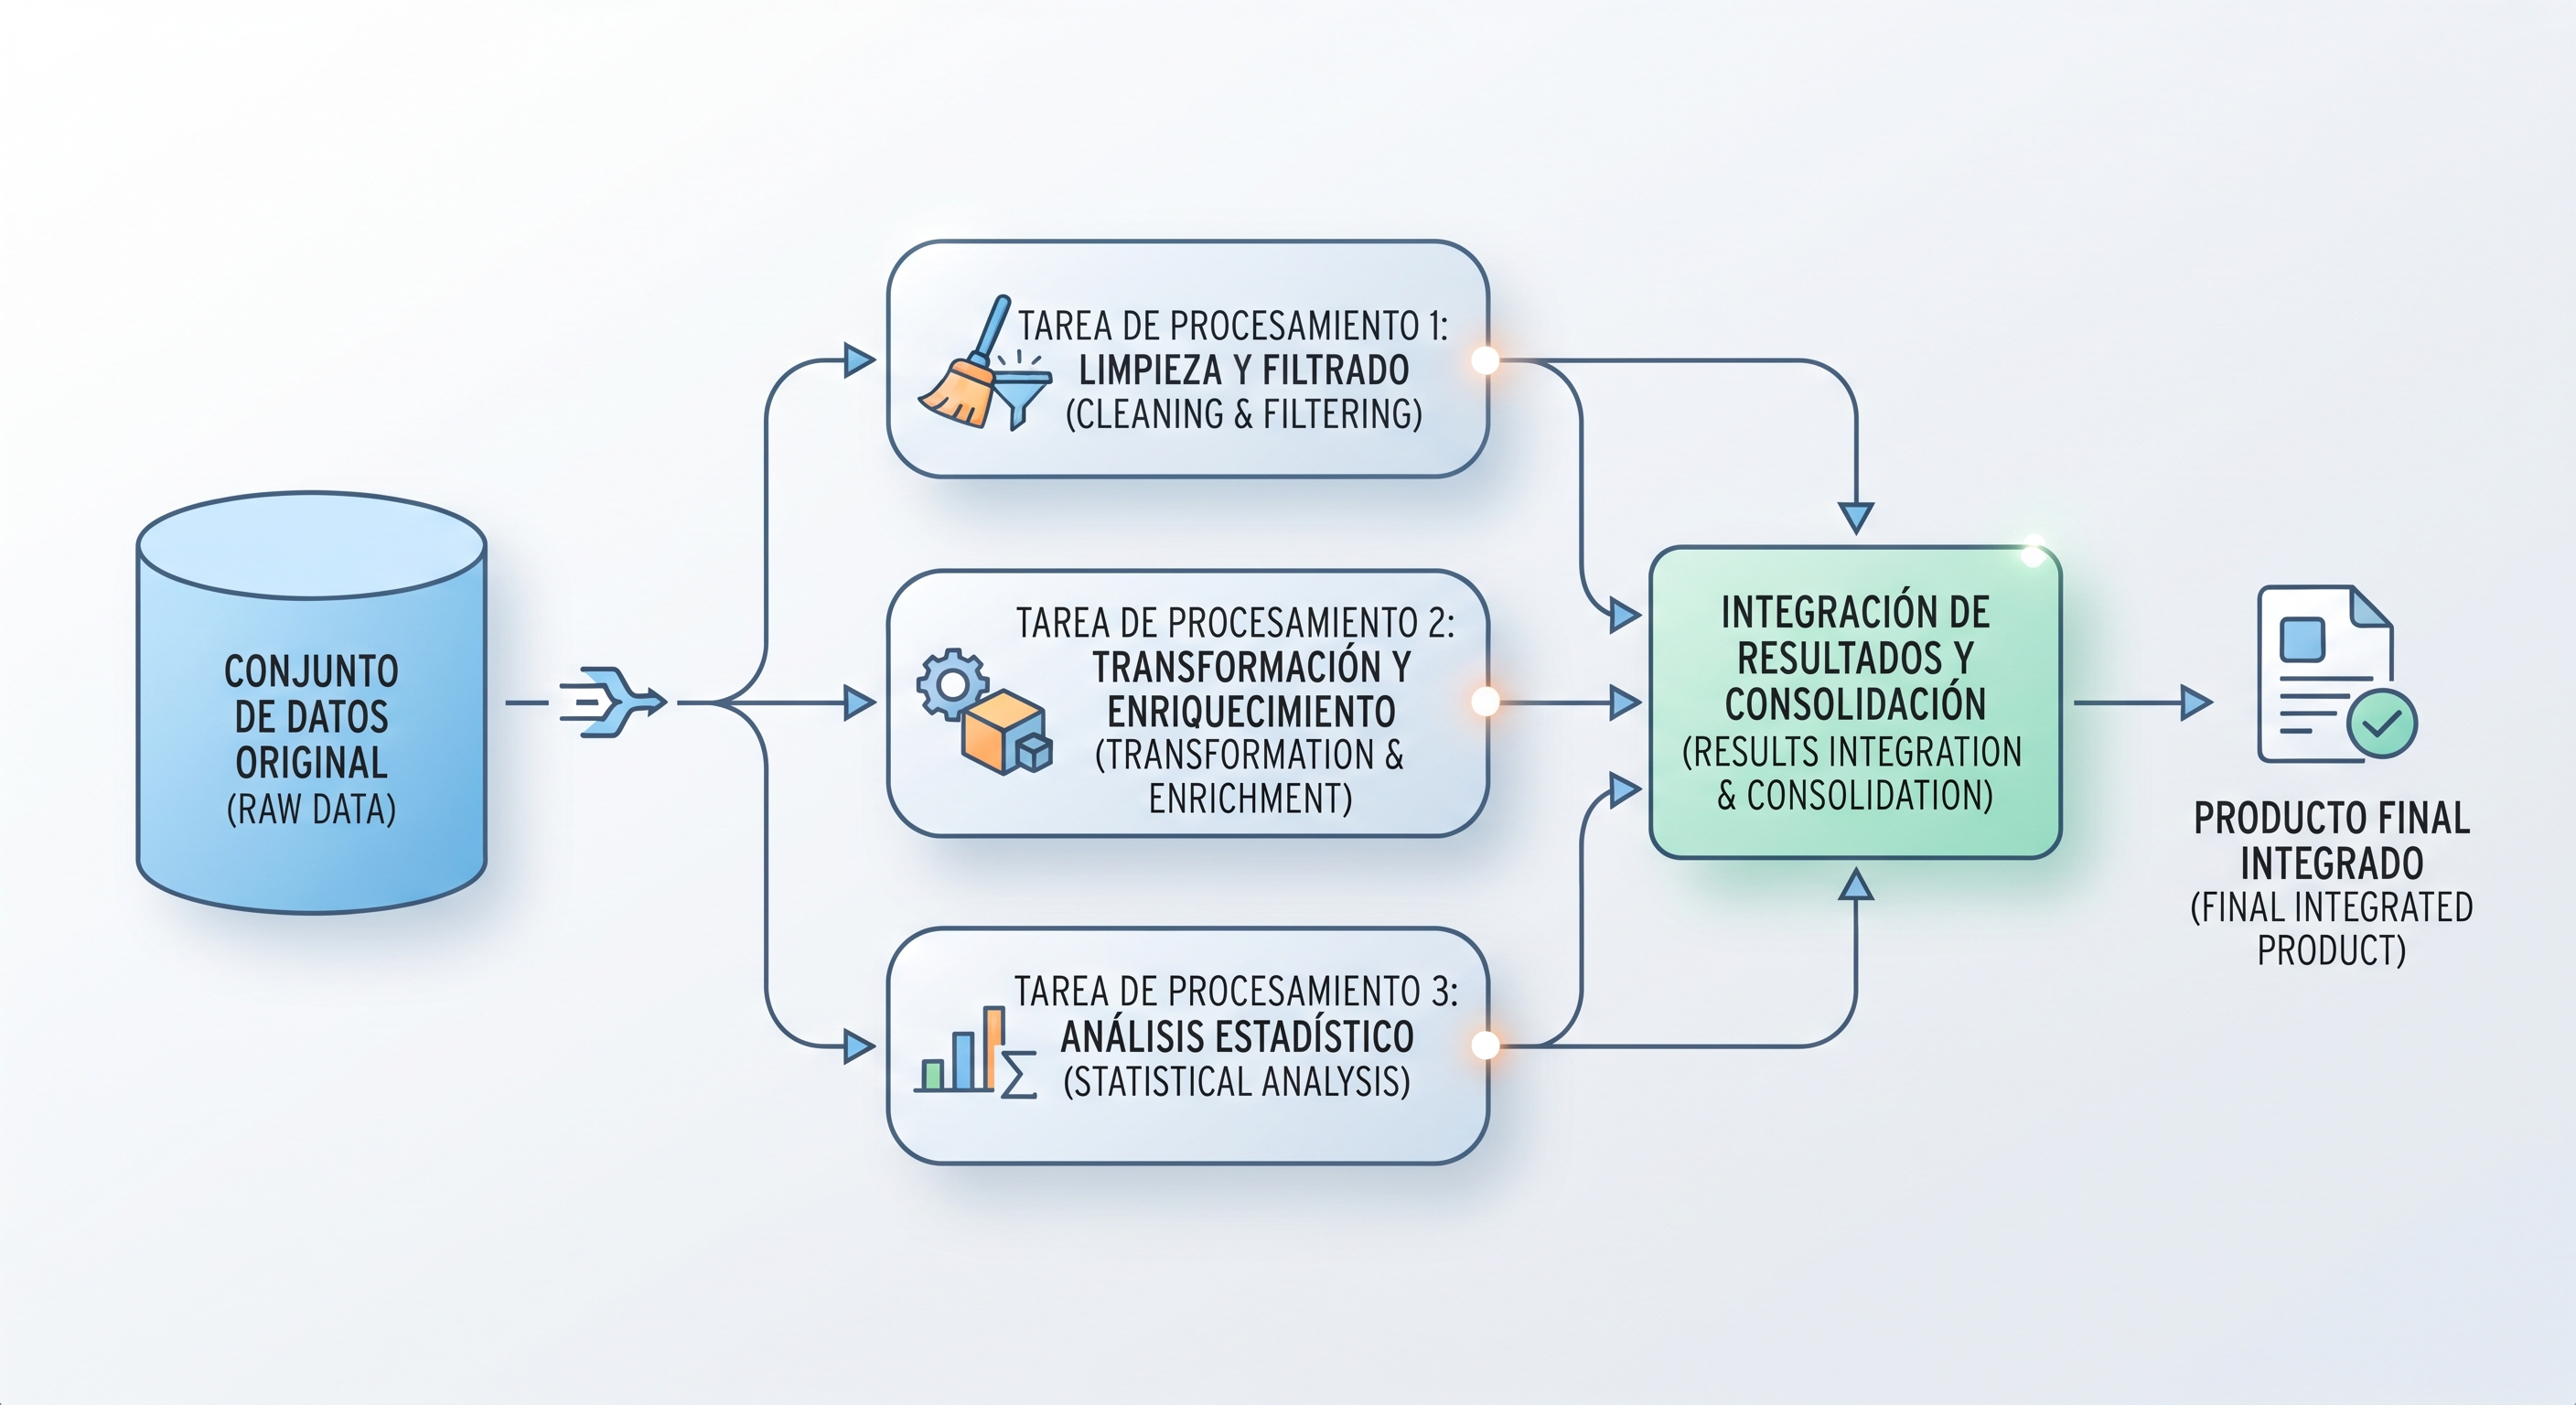
Esta valor consiste en trasladar operaciones de tratamiento y análisis a clústeres, con capacidad de paralelización y escalabilidad. Sin embargo, la distribución añade costes de comunicación, configuración y gestión de recursos (por esto no es la primera elección para cualquier dataset).
La formación en herramientas Big Data del Máster de la UNED incluye Spark y Databricks, lo que ofrece un contexto para comprender cuándo el análisis local resulta insuficiente y cómo incorporar procesamiento distribuido.
9-Cómo combinar las librerías en un proyecto
En un flujo habitual, NumPy y pandas sirven para cálculo y transformación. Matplotlib, Seaborn o Plotly para explorar y comunicar. Statsmodels para inferencia. Scikit-learn o XGBoost para modelos predictivos. PyTorch, TensorFlow o Transformers para tareas profundas y generativas. Y PySpark para cargas distribuidas.
No es necesario incorporar todas las bibliotecas. La selección debe atender a cinco criterios: naturaleza del problema, estructura y tamaño de los datos, exigencias de rendimiento, interpretabilidad y entorno de despliegue.
Además, la calidad profesional exige fijar versiones, gestionar dependencias, documentar transformaciones, realizar pruebas y conservar la trazabilidad. Un entorno reproducible facilita auditorías y actualizaciones, a la vez que reduce los errores derivados de diferencias entre equipos.
Conclusiones
Las librerías de Python para Data Science forman un ecosistema complementario. NumPy y SciPy proporcionan cálculo numérico y científico; pandas y Polars permiten transformar tablas; Matplotlib, Seaborn y Plotly facilitan la exploración y comunicación; statsmodels cubre modelización estadística; scikit-learn y XGBoost abordan Machine Learning; PyTorch, TensorFlow y Transformers amplían las posibilidades del Deep Learning. Y PySpark extiende el análisis hacia arquitecturas distribuidas.
El criterio fundamental es comprender qué función cumple cada librería y cómo contribuye al resultado analítico. Esta perspectiva permite construir procesos reproducibles y elegir soluciones acordes con el problema.
En la formación especializada, comprender el ecosistema en su conjunto resulta tan importante como aprender cada paquete por separado, el conocimiento técnico adquiere valor cuando se integra en una metodología coherente de análisis de datos.
FAQ
¿Qué librería de Python conviene aprender primero?
NumPy y pandas constituyen un buen punto de partida, dado que proporcionan las estructuras y operaciones necesarias para el trabajo numérico y tabular.
¿Qué diferencia existe entre pandas y NumPy?
NumPy está especializado en arrays y operaciones numéricas; pandas incorpora estructuras etiquetadas, como DataFrame, destinadas a la manipulación de tablas y series temporales.
¿Qué librería se utiliza para Machine Learning?
Scikit-learn es una opción de referencia para algoritmos convencionales y evaluación de modelos. XGBoost destaca en métodos de gradient boosting.
¿Qué diferencia hay entre PyTorch y TensorFlow?
Ambas herramientas permiten construir redes neuronales profundas. La elección depende del ecosistema, las necesidades de desarrollo y el entorno de despliegue.
¿Cuándo conviene utilizar PySpark?
Cuando el volumen, la velocidad o las necesidades de procesamiento justifican distribuir el trabajo entre varios nodos.
¿Es necesario aprender todas las librerías?
No. Conviene dominar primero un conjunto básico y ampliar el repertorio según las tareas profesionales y la complejidad de los proyectos.
Referencias bibliográficas
Apache Software Foundation. (2026). PySpark documentation (version 4.2.0). https://spark.apache.org/docs/latest/api/python/index.html
Hugging Face. (2026). Transformers documentation (version 5.19.0). https://huggingface.co/docs/transformers/main/index
Matplotlib Development Team. (2026). Matplotlib documentation (version 3.11.2). https://matplotlib.org/stable/
NumPy Developers. (2026). NumPy documentation (version 2.5). https://numpy.org/doc/stable/
Pandas Development Team. (2026). pandas documentation (version 3.0.6). https://pandas.pydata.org/docs/
Plotly Technologies Inc. (2026). Plotly Python graphing library documentation (version 7.1.0). https://plotly.com/python/
Polars. (2026). Polars user guide. https://docs.pola.rs/user-guide/
PyTorch Contributors. (2026). PyTorch documentation (version 2.14). https://docs.pytorch.org/docs/
scikit-learn Developers. (2026). scikit-learn documentation (version 1.9.1). https://scikit-learn.org/stable/
SciPy Community. (2026). SciPy documentation (version 1.18.1). https://docs.scipy.org/doc/scipy/
Seaborn Developers. (s. f.). Seaborn user guide and tutorial. https://seaborn.pydata.org/tutorial.html
Stack Overflow. (2025). 2025 Stack Overflow Developer Survey. https://survey.stackoverflow.co/2025/
Statsmodels Developers. (2026). statsmodels user guide (version 0.14.6). https://www.statsmodels.org/stable/user-guide.html
TensorFlow. (s. f.). TensorFlow basics. https://www.tensorflow.org/guide/basics
Universidad Nacional de Educación a Distancia. (s. f.). Máster en Big Data y Data Science: contenido del programa. https://www.masterbigdataonline.com/contenido.html
XGBoost Developers. (s. f.). XGBoost documentation. https://xgboost.readthedocs.io/