Introducción
Guía Data Science - R para Data Science: Empecemos por decir que el análisis de datos requiere disponer de grandes cantidades de información. Para transformar datos en conocimiento es necesario combinar métodos estadísticos, programación, visualización y criterios metodológicos que permitan evaluar la calidad de los resultados. En este contexto, R ocupa una posición especialmente relevante dentro del ecosistema de Data Science.
R fue concebido como un lenguaje y entorno para la computación estadística y los gráficos. El propio proyecto R destaca entre sus capacidades el modelado lineal y no lineal, los contrastes estadísticos, el análisis de series temporales, la clasificación, el clustering y la producción de gráficos de calidad para publicación.
El ecosistema actual de R incorpora herramientas para importar, transformar y visualizar datos, construir modelos estadísticos y de Machine Learning, generar informes reproducibles y desarrollar aplicaciones interactivas. Además, el lenguaje continúa evolucionando: R 4.6.1, conocido como Happy Hop, fue publicado el 24 de junio de 2026.
Para un principiante, la amplitud del ecosistema podría resultar inicialmente compleja. La estrategia más adecuada consiste en aprender R desde la lógica del análisis de datos, es decir, comprender objetos y estructuras, importar información, limpiarla, explorarla, visualizarla y finalmente aplicar modelos estadísticos o predictivos.
¿Qué es R y para qué sirve?
R es un lenguaje de programación especializado en estadística, análisis de datos y representación gráfica. A diferencia de lenguajes concebidos inicialmente para desarrollo generalista, R nació estrechamente ligado a la investigación estadística y científica.
Lo anterior explica una de las principales ventajas: diversas técnicas estadísticas que requieren bibliotecas adicionales o configuraciones específicas en otros entornos forman parte de su ecosistema natural.
R es utilizable para describir distribuciones, realizar inferencia estadística, ajustar modelos, analizar series temporales, construir predicciones, realizar simulaciones y representar resultados. También se integra con bases de datos y otras tecnologías de Data Science.
La arquitectura basada en paquetes amplía considerablemente estas posibilidades. Los paquetes permiten distribuir código, funciones, documentación, datos y pruebas de manera reutilizable y reproducible.
¿Por dónde empezar con R?
Instalar R y elegir un entorno de trabajo
El primer paso consiste en instalar R desde el proyecto oficial y disponer de un entorno adecuado para desarrollar análisis.
RStudio, mantenido actualmente por Posit, continúa siendo una de las interfaces más utilizadas para trabajar con R. La versión actual en documentación muestra soporte para RStudio Desktop y entornos server, con una interfaz que integra consola, editor, visualización gráfica, depuración y gestión del espacio de trabajo.
Para un principiante, RStudio ofrece una ventaja importante, permite concentrar en una misma aplicación el código, los gráficos, los archivos y la documentación del proyecto.
Comprender los objetos de R
Antes de analizar datos conviene comprender cómo R representa la información. Entre las estructuras fundamentales se encuentran los vectores, matrices, listas y data frames. Los vectores almacenan valores de un mismo tipo, luego las matrices organizan información en dos dimensiones, veremos que las listas permiten combinar objetos heterogéneos y los data frames representan tablas de datos.
Este último concepto será fundamental para el análisis estadístico. En efecto, una tabla viene a contener variables numéricas, categóricas, fechas o cadenas de texto y utilizarse posteriormente en procesos de transformación y modelización.
El objetivo inicial no es memorizar toda la sintaxis, sino comprender la relación entre objeto, estructura y operación.
Los paquetes son el ecosistema que hace posible el análisis
Una de las mayores fortalezas de R reside en sus paquetes. El usuario amplia el lenguaje según las necesidades concretas de cada proyecto.
Para análisis de datos existe un ecosistema especialmente importante: tidyverse, una colección de paquetes diseñada alrededor de principios comunes para la ciencia de datos. Entre ellos se encuentran herramientas para importar, transformar, ordenar y visualizar información.
El libro R for Data Science, en su segunda edición, estructura buena parte de su metodología alrededor de estos principios y aborda visualización, transformación, importación, programación y comunicación reproducible de resultados. Este enfoque resulta pedagógicamente interesante porque permite aprender el lenguaje mientras se resuelven problemas reales de datos.
Importar datos con R
Un análisis suele comenzar fuera de R. Los datos pueden encontrarse en archivos CSV, hojas de cálculo, bases de datos, APIs o formatos especializados.
El paquete readr, integrado en tidyverse, facilita la importación de archivos de texto rectangulares y permite trabajar con nombres de variables, tipos de datos y valores ausentes. La guía de R for Data Science sitúa precisamente la importación como una de las primeras etapas de cualquier flujo práctico de análisis.
También es importante comprender que la importación no es una operación mecánica. Al leer datos hay que comprobar si R ha interpretado correctamente los tipos de variables, las fechas, los valores ausentes y los separadores.
Claramente, un archivo podría parecer correcto visualmente y, sin embargo, contener números almacenados como texto, fechas inconsistentes o códigos que requieren interpretación específica.
El concepto de datos ordenados o tidy data
Una de las ideas centrales del ecosistema moderno de R es la de tidy data. Según la definición desarrollada en tidyr, cada variable debe corresponder a una columna, cada observación a una fila y cada valor a una celda. Esta estructura facilita las operaciones de transformación y reduce la complejidad del procesamiento.
La importancia de esta idea es que representar correctamente los datos permite separar la estructura de la información de las operaciones que posteriormente se realizan sobre ella. Por esto, antes de construir un modelo estadístico o una visualización sofisticada conviene comprobar que el dataset tiene una estructura coherente.
Dplyr y la transformación de los datos
Una vez importada la información comienza una de las fases más importantes: transformar los datos.
Dplyr proporciona una sintaxis basada en verbos para operaciones habituales como seleccionar variables, filtrar observaciones, crear nuevas columnas, ordenar registros y generar resúmenes. También permite agrupar datos y combinar tablas.
Sus operaciones principales pueden entenderse como esta secuencia lógica:
Seleccionar → filtrar → transformar → agrupar → resumir
Este modelo facilita la lectura del código y no permite construir análisis reproducibles. La ventaja profesional consiste en que la transformación definida mediante código puede repetirse sobre nuevos datos sin reconstruir manualmente todo el proceso.
Análisis exploratorio, para comprender antes de modelar
La exploración constituye una etapa esencial. Antes de aplicar un algoritmo sofisticado, el analista debe saber qué contienen sus datos.
El análisis exploratorio permite estudiar distribuciones, relaciones entre variables, diferencias entre grupos, valores atípicos y ausencia de información. Las estadísticas descriptivas (media, mediana, desviación estándar y cuantiles) constituyen herramientas básicas para esta primera aproximación.
R posee una amplia tradición en este campo porque integra la computación estadística con la representación gráfica. El propio proyecto oficial destaca entre las características centrales las técnicas estadísticas y la producción de gráficos de calidad.
Esta etapa permite, por otra parte, detectar problemas que podrían afectar posteriormente a cualquier modelo, como sesgos de muestreo, variables mal codificadas, observaciones imposibles o distribuciones extremadamente asimétricas.
Visualización con ggplot2
La visualización es otro de los pilares del ecosistema R. Ggplot2 utiliza una aproximación basada en la Grammar of Graphics, donde el usuario proporciona datos, define cómo se relacionan las variables con diferentes propiedades visuales y construye el gráfico mediante capas. La versión actual de la documentación corresponde a ggplot2 4.0.3.
Este enfoque permite construir progresivamente gráficos de dispersión, histogramas, diagramas de barras, cajas, series temporales y representaciones más complejas. Por supuesto, lo importante no es aprender muchos tipos de gráficos, sino saber cuál responde mejor a una determinada pregunta.
Por ejemplo, una distribución puede examinarse mediante un histograma, una relación entre dos variables cuantitativas puede estudiarse con un gráfico de dispersión y la evolución temporal de una magnitud puede representarse mediante una serie temporal. La visualización, por lo tanto, es una herramienta analítica.
R para estadística
La estadística constituye uno de los ámbitos donde R presenta una ventaja histórica. El lenguaje permite trabajar con estadística descriptiva, inferencia, regresión, análisis de varianza, modelos lineales y numerosas técnicas especializadas. También dispone de herramientas para series temporales, clasificación y clustering.
Esta relación entre programación y estadística resulta especialmente importante para Data Science. Ejecutar un procedimiento mediante una función no garantiza comprender su significado. El analista de datos demanda conocer sus supuestos, interpretar parámetros y valorar la incertidumbre asociada a los resultados.
En este sentido, R una herramienta que favorece la práctica analítica basada en métodos estadísticos explícitos y reproducibles.
R y Machine Learning
Aunque R está especialmente asociado con la estadística, también desempeña un papel importante en Machine Learning.
El ecosistema tidymodels proporciona un conjunto de paquetes para modelización y aprendizaje automático siguiendo principios coherentes con tidyverse. Incluye herramientas para división y remuestreo de datos, especificación de modelos, ajuste, evaluación y optimización de hiperparámetros.
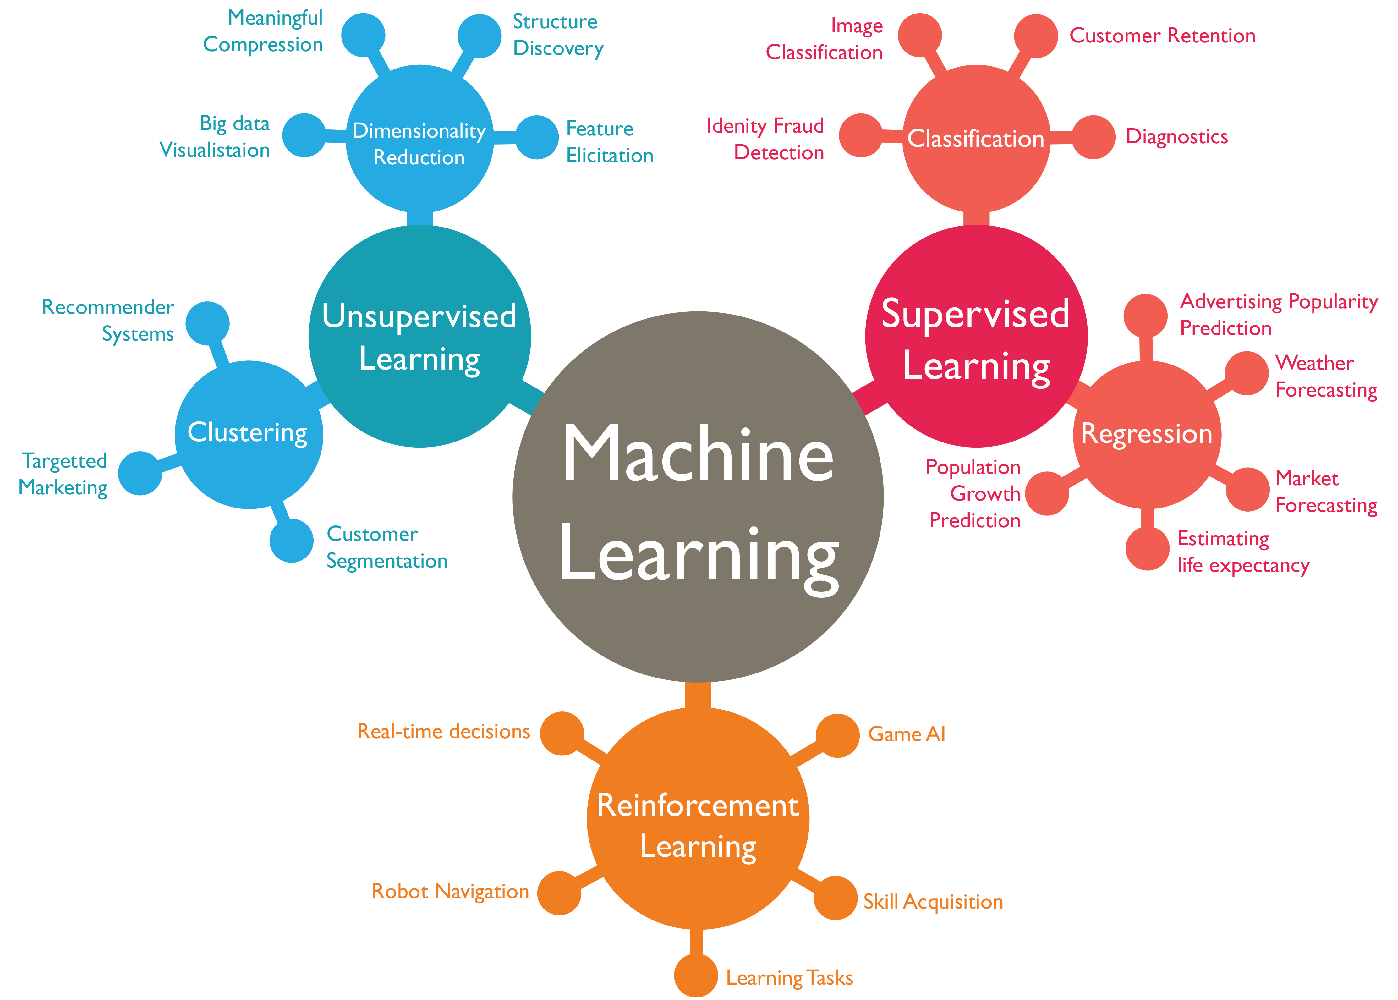
Esto permite construir procesos completos:
Datos → preprocesamiento → entrenamiento → validación → evaluación → predicción
La ventaja consiste en separar conceptualmente las diferentes fases y hacerlas reproducibles.
Para quienes comienzan, es recomendable entender primero modelos relativamente sencillos —por ejemplo, regresión lineal o logística— antes de avanzar hacia algoritmos de mayor complejidad.
R y análisis de series temporales
Las series temporales constituyen otro ámbito especialmente adecuado para R. Datos financieros, indicadores económicos, demanda energética, tráfico, producción o temperaturas tienen una dimensión temporal que exige métodos específicos. No basta con ordenar los registros cronológicamente, pasa a ser necesario analizar tendencias, estacionalidad, autocorrelación y posibles cambios estructurales.
El ecosistema R cuenta con paquetes especializados para este tipo de análisis y tidymodels incorpora incluso herramientas y ejemplos de remuestreo temporal y modelización de series temporales.
Esta capacidad resulta particularmente relevante en ámbitos económicos y empresariales, donde las decisiones suelen depender de la evolución histórica y de las previsiones futuras.
R, reproducibilidad y comunicación científica
Una de las mayores ventajas de R es que el análisis puede convertirse en un documento reproducible.
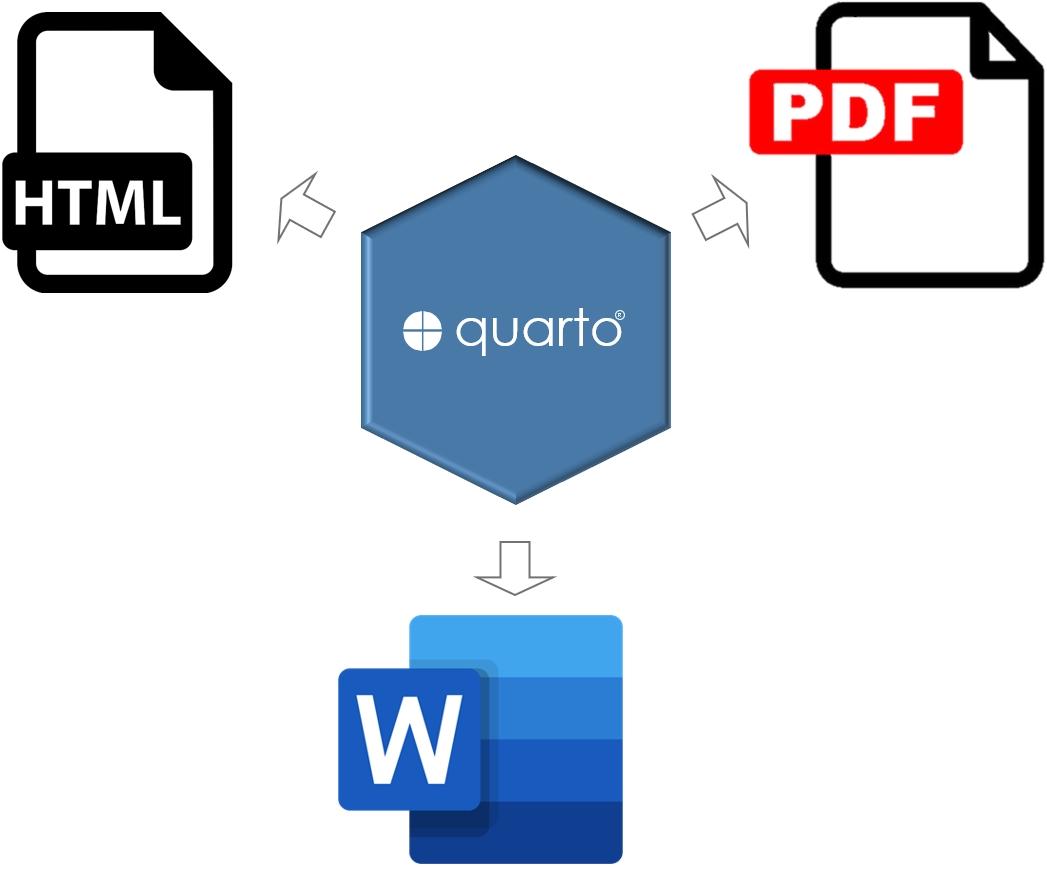
Quarto, sucesor multilenguaje del enfoque de R Markdown, permite combinar texto, código ejecutable, resultados, gráficos y referencias en un mismo documento. El código puede volver a ejecutarse automáticamente cuando se genera el documento final.
Esto tiene importantes implicaciones científicas y profesionales. En lugar de presentar únicamente el resultado final, el analista de datos puede conservar la secuencia de operaciones que lo produjo.
Y la reproducibilidad facilita auditorías, actualizaciones, colaboración entre investigadores y reutilización del trabajo. Sin olvidar que permite generar documentos HTML, PDF, libros, informes y otros formatos a partir de una misma fuente.
R dentro de la formación en Big Data y Data Science
Aprender R adquiere mayor valor cuando se sitúa dentro de una formación integral. Recordemos que científico de datos no trabaja exclusivamente con un X lenguaje, necesita combinar programación, estadística, bases de datos, visualización, Machine Learning y tecnologías para gestionar información a gran escala.
Existe un lugar donde esa integración estratégica de habilidades se ha convertido en norma y sistema pedagógico: el Máster en Big Data y Data Science aplicados a la Economía y a la Administración y Dirección de Empresas de la UNED.
La incorporación de R a este itinerario formativo permite abordar una dimensión estadística y analítica complementaria a otras herramientas del ecosistema Big Data.
¿R o Python para análisis de datos?
La comparación entre R y Python suele plantearse como si fuera necesario elegir un único lenguaje, pero desde una perspectiva profesional, la cuestión es más compleja.
R destaca especialmente en estadística, investigación cuantitativa y visualización, mientras que Python presenta una presencia muy amplia en Machine Learning, ingeniería de software e inteligencia artificial. Ambos cuentan con ecosistemas extensos y pueden utilizarse conjuntamente.
La encuesta de Stack Overflow de 2025 confirma, además, el crecimiento de Python y su fuerte asociación con IA y Data Science, pero esta evolución no elimina la utilidad de R en análisis estadístico.
En múltiples proyectos, la combinación resulta más productiva que una competencia rígida entre lenguajes. La elección debe responder a los requisitos técnicos, al tipo de análisis, a la infraestructura disponible y a las competencias del equipo.
Un itinerario recomendado para principiantes
Una estudiante que comienza con R puede seguir un recorrido progresivo. Primero, conviene aprender la sintaxis básica y las estructuras fundamentales del lenguaje. Después, trabajar con data.frame y datos tidy. A continuación, introducir la importación y transformación con readr, dplyr y tidyr.
El siguiente paso debería ser la visualización con ggplot2 y el análisis exploratorio. Una vez consolidada esta base, resulta adecuado avanzar hacia estadística, modelización y tidymodels. Finalmente, el estudiante puede incorporar series temporales, bases de datos, programación reproducible con Quarto y herramientas específicas de Big Data.
La lógica es progresiva: primero comprender los datos, después analizarlos, finalmente modelarlos y comunicar resultados.
Conclusiones
R continúa siendo una herramienta fundamental para el análisis estadístico y científico de datos. Su principal fortaleza en un ecosistema que integra manipulación de información, visualización, modelización estadística, Machine Learning y generación reproducible de informes.
Para quien comienza, el aprendizaje debe organizarse alrededor del ciclo de análisis de datos. Comprender las estructuras del lenguaje, importar información correctamente, transformarla, explorarla y representarla constituye una base mucho más sólida que intentar memorizar funciones de manera aislada.
Herramientas como dplyr, tidyr y ggplot2 permiten desarrollar un flujo coherente de análisis, mientras tidymodels amplía las posibilidades hacia la modelización y Machine Learning. Quarto añade una dimensión fundamental, consistente en documentar y reproducir el proceso completo.
Al hablar de Big Data y Data Science, R debe entenderse como pieza dentro de una arquitectura de competencias más amplia. Saber utilizar un lenguaje resulta útil, comprender qué datos utilizar, qué método aplicar, cómo evaluar sus resultados y cómo comunicar las conclusiones es lo que convierte ese conocimiento técnico en capacidad profesional. Y es ahí donde encontramos una de las grandes diferencias del Máster en Big Data y Data Science de la UNED.
FAQ sobre R para análisis de datos
¿Qué es R?
R es un lenguaje y entorno de software libre orientado principalmente a la computación estadística y la representación gráfica. Incluye herramientas para modelización, análisis estadístico, clasificación, clustering y otras técnicas de tratamiento de datos.
¿R es adecuado para principiantes?
Sí. Aunque requiere aprender conceptos de programación, su ecosistema dispone de herramientas y materiales específicamente orientados al análisis de datos. RStudio facilita además el trabajo mediante una interfaz integrada.
¿Qué paquetes de R debería aprender primero?
Para análisis de datos es recomendable comenzar por tidyverse, especialmente dplyr, tidyr y ggplot2. Posteriormente pueden incorporarse herramientas de modelización como tidymodels.
¿Qué es RStudio?
RStudio es un entorno de desarrollo integrado para trabajar con R que reúne consola, editor, herramientas gráficas, depuración y gestión de proyectos. La plataforma continúa desarrollándose activamente en 2026.
¿R sirve para Machine Learning?
Sí. El ecosistema tidymodels proporciona herramientas para construir, ajustar, validar y evaluar modelos de Machine Learning y análisis estadístico.
¿Cuál es mejor para Data Science: R o Python?
No existe una respuesta universal. R presenta una posición especialmente fuerte en estadística, análisis cuantitativo y visualización, mientras Python posee un ecosistema muy amplio en Data Science, Machine Learning e inteligencia artificial. En proyectos profesionales ambos pueden complementarse.
¿R se utiliza en Big Data?
Sí. R puede conectarse con bases de datos, herramientas de procesamiento y otros componentes de arquitecturas de datos. Su utilidad dependerá de la escala y naturaleza del proyecto y de cómo se integre dentro de la infraestructura tecnológica.
¿Qué relación tiene R con el Máster en Big Data y Data Science de la UNED?
El programa de Máster de la UNED en Big Data y Data Science aplicados a la Economía y a la Administración y Dirección de Empresas integra contenidos de Data Science y Big Data, herramientas Big Data, análisis multivariante y minería de datos, dentro de una estructura de 60 ECTS. R aporta una herramienta especialmente valiosa para la dimensión estadística y analítica de ese recorrido.
Referencias bibliográficas
R Core Team. (2026). R: A language and environment for statistical computing. R Foundation for Statistical Computing. https://www.r-project.org/
R Core Team. (2026). R 4.6.1 (Happy Hop). The R Project for Statistical Computing. https://www.r-project.org/
Posit. (2026). RStudio IDE user guide. https://docs.posit.co/ide/user/
Wickham, H., Çetinkaya-Rundel, M., & Grolemund, G. (2023). R for data science: Import, tidy, transform, visualize, and model data (2nd ed.). O’Reilly Media. https://r4ds.hadley.nz/
Wickham, H., François, R., Henry, L., Müller, K., & Vaughan, D. (2026). dplyr: A grammar of data manipulation (Version 1.2.1) [R package]. https://dplyr.tidyverse.org/
Wickham, H., Vaughan, D., & Girlich, M. (2026). tidyr: Tidy messy data [R package]. https://tidyr.tidyverse.org/
Wickham, H. (2016). ggplot2: Elegant graphics for data analysis (2nd ed.). Springer. https://doi.org/10.1007/978-3-319-24277-4
Kuhn, M., & Silge, J. (2022). Tidy modeling with R: A framework for modeling in the tidyverse. O’Reilly Media. https://www.tmwr.org/
Wickham, H., & Bryan, J. (2023). R packages: Organize, test, document, and share your code (2nd ed.). O’Reilly Media. https://r-pkgs.org/
Posit. (2026). Quarto: An open-source scientific and technical publishing system. https://quarto.org/
Stack Overflow. (2025). 2025 Stack Overflow Developer Survey. https://survey.stackoverflow.co/2025/
Universidad Nacional de Educación a Distancia. (2026). Big Data y Data Science aplicados a la Economía y a la Administración y Dirección de Empresas. Formación Permanente UNED. https://formacionpermanente.uned.es/tp_actividad/actividad/big-data-y-data-science-aplicados-a-la-economia-y-a-la-administracion-y-direccion-de-empresas