Introducción
Guía Data Science - Machine Learning: Hablar de Machine Learning significa hablar de métodos diferentes para extraer regularidades de los datos. No existe un algoritmo universalmente adecuado para cualquier problema, la elección depende del tipo de variable objetivo, la estructura de los datos, el volumen disponible, la necesidad de interpretar el modelo y coste de los errores.
La documentación actual de scikit-learn organiza el aprendizaje automático en familias como modelos lineales, máquinas de vectores soporte, vecinos, árboles de decisión, métodos de ensamblado, Naive Bayes y redes neuronales, además de algoritmos no supervisados como clustering, modelos de mezcla y reducción de dimensionalidad. (scikit-learn.org)
Comprender para qué sirve cada algoritmo es más útil que memorizar su sintaxis. Una regresión logística responde a una pregunta diferente de un árbol de decisión, K-means persigue un objetivo distinto de DBSCAN y La red neuronal no debería elegirse únicamente porque pertenezca a x tecnología avanzada.
¿Cómo se clasifican los principales algoritmos?
La primera división es metodológica. En aprendizaje supervisado, el modelo dispone de una variable objetivo conocida y aprende a predecirla. En el no supervisado, esa respuesta no existe y el algoritmo intenta descubrir estructuras presentes en los datos.
Dentro del aprendizaje supervisado destacan la regresión y la clasificación. En el no supervisado, el clustering y la reducción de dimensionalidad ocupan un lugar central.
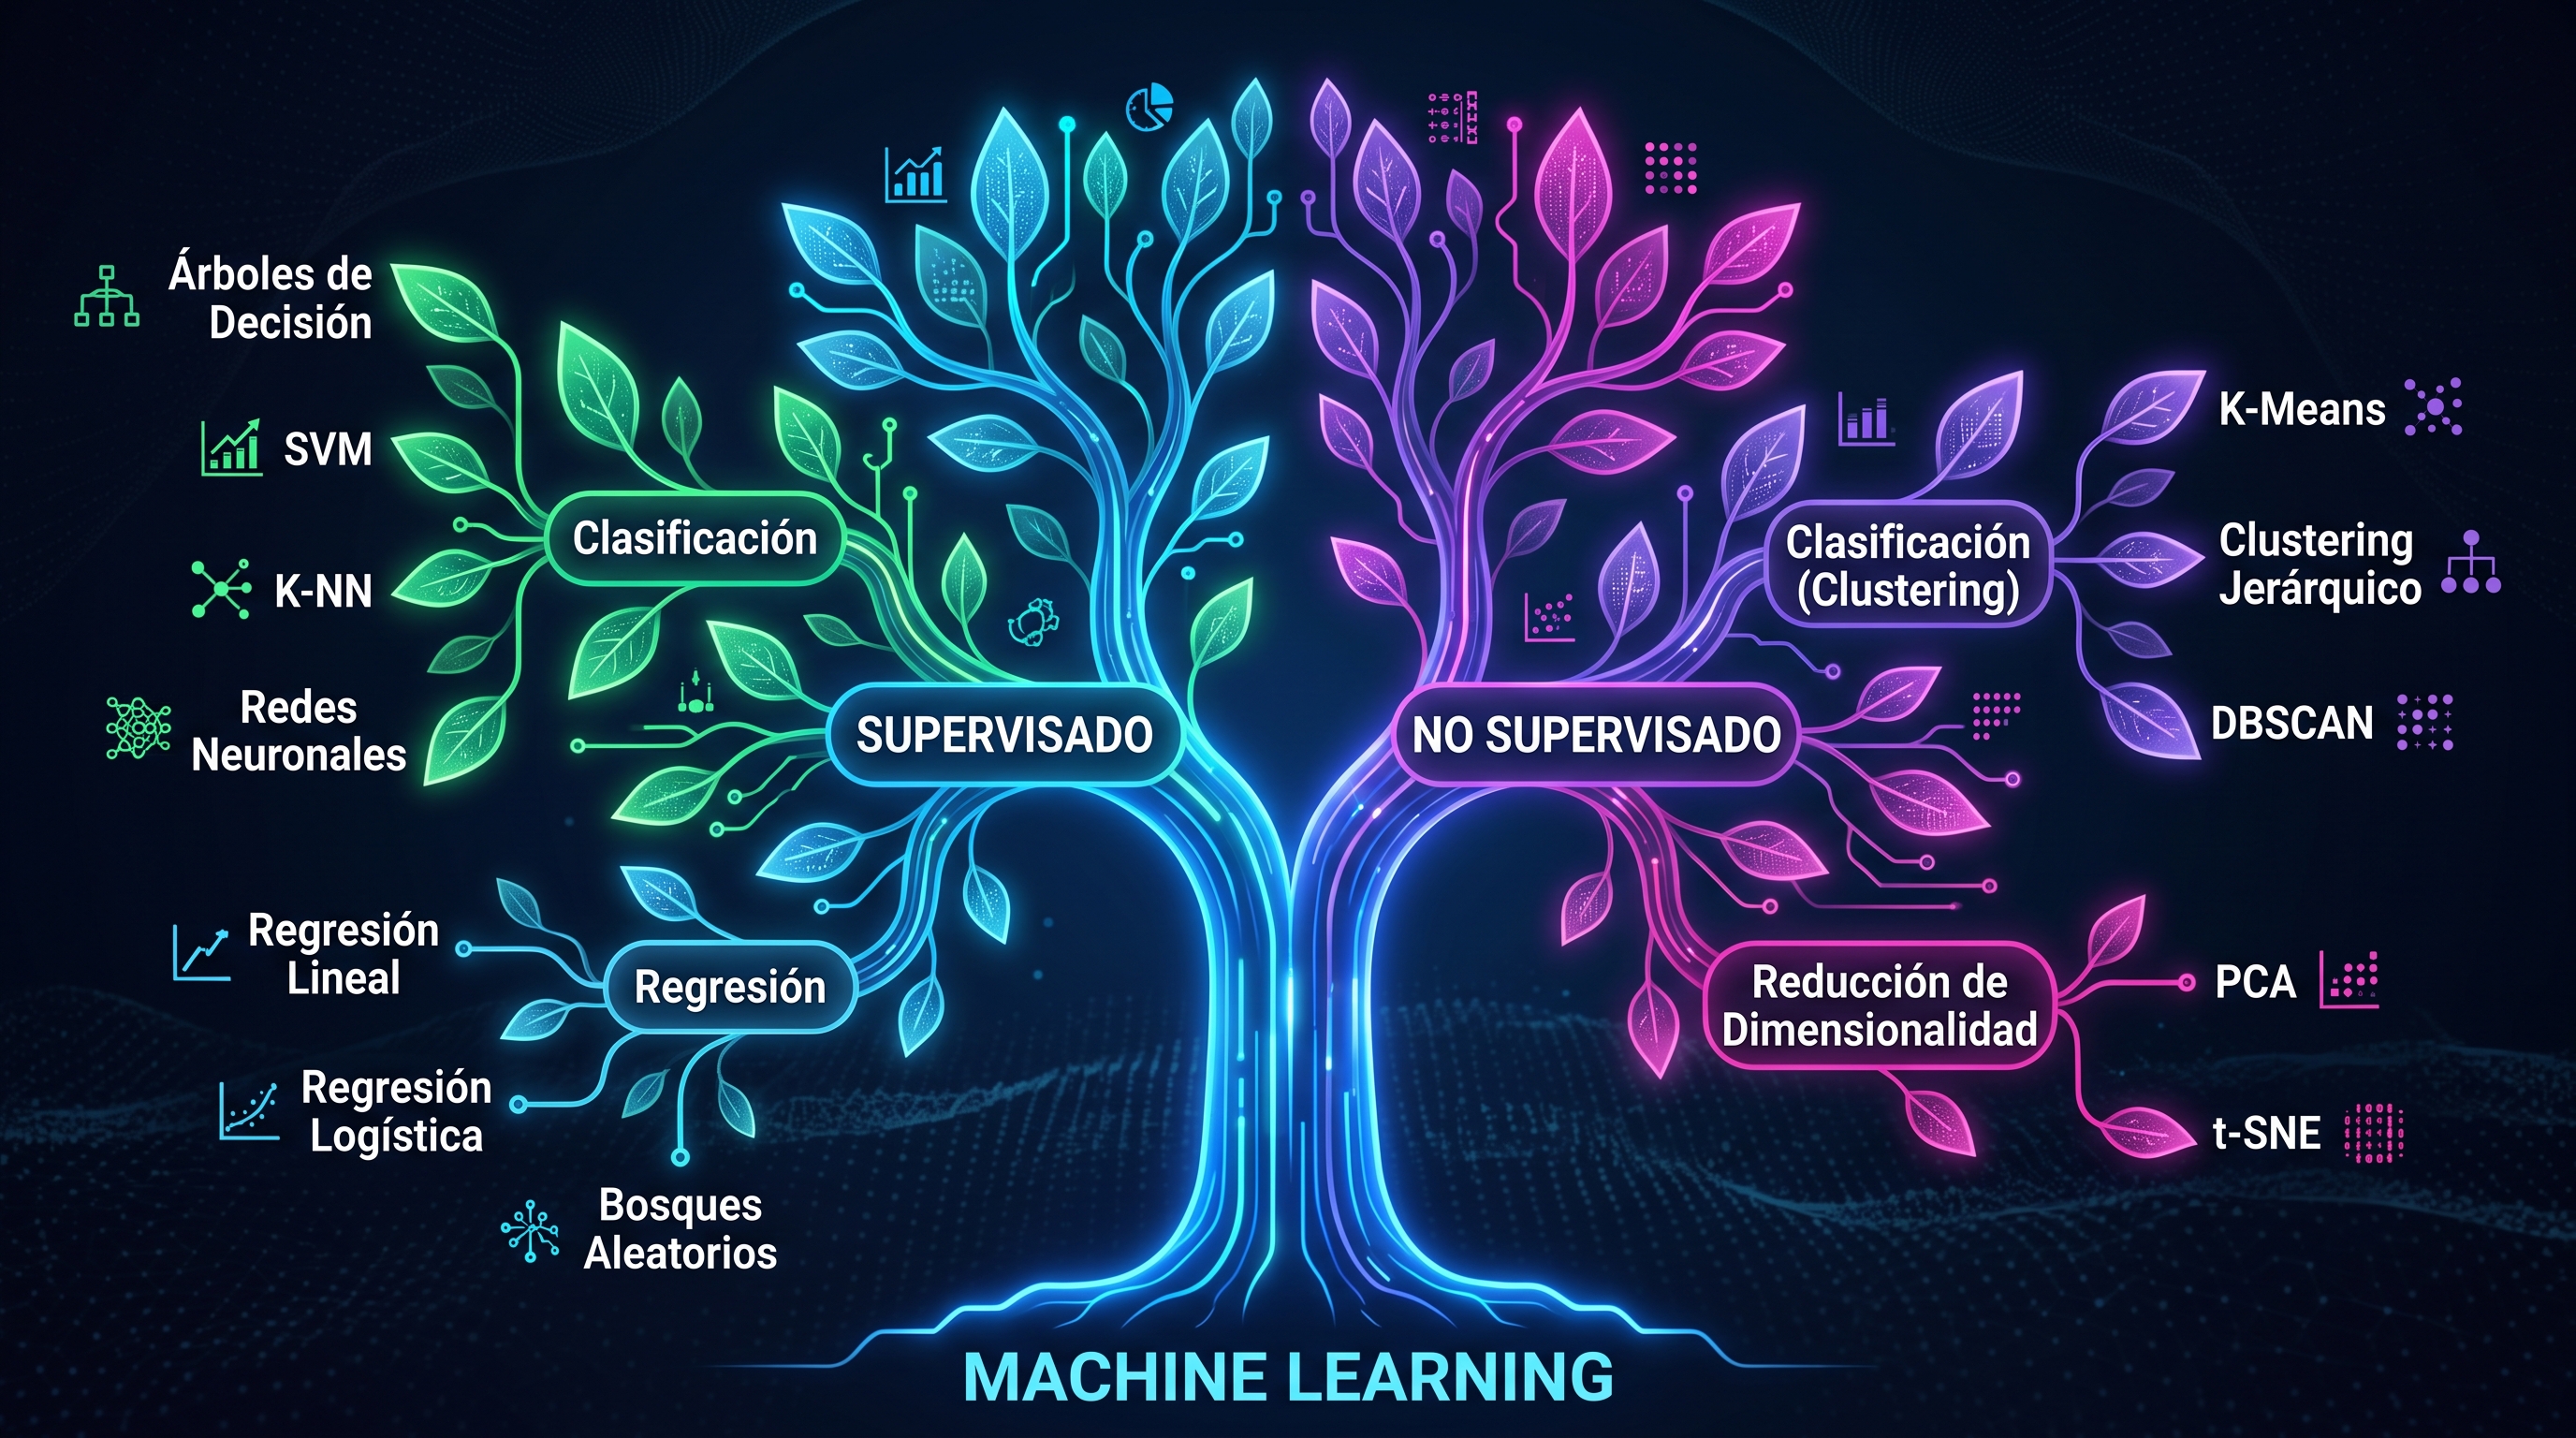
A partir de la distinción anterior, los principales algoritmos pueden entenderse según el problema que pretenden resolver.
Regresión lineal y estimar relaciones cuantitativas
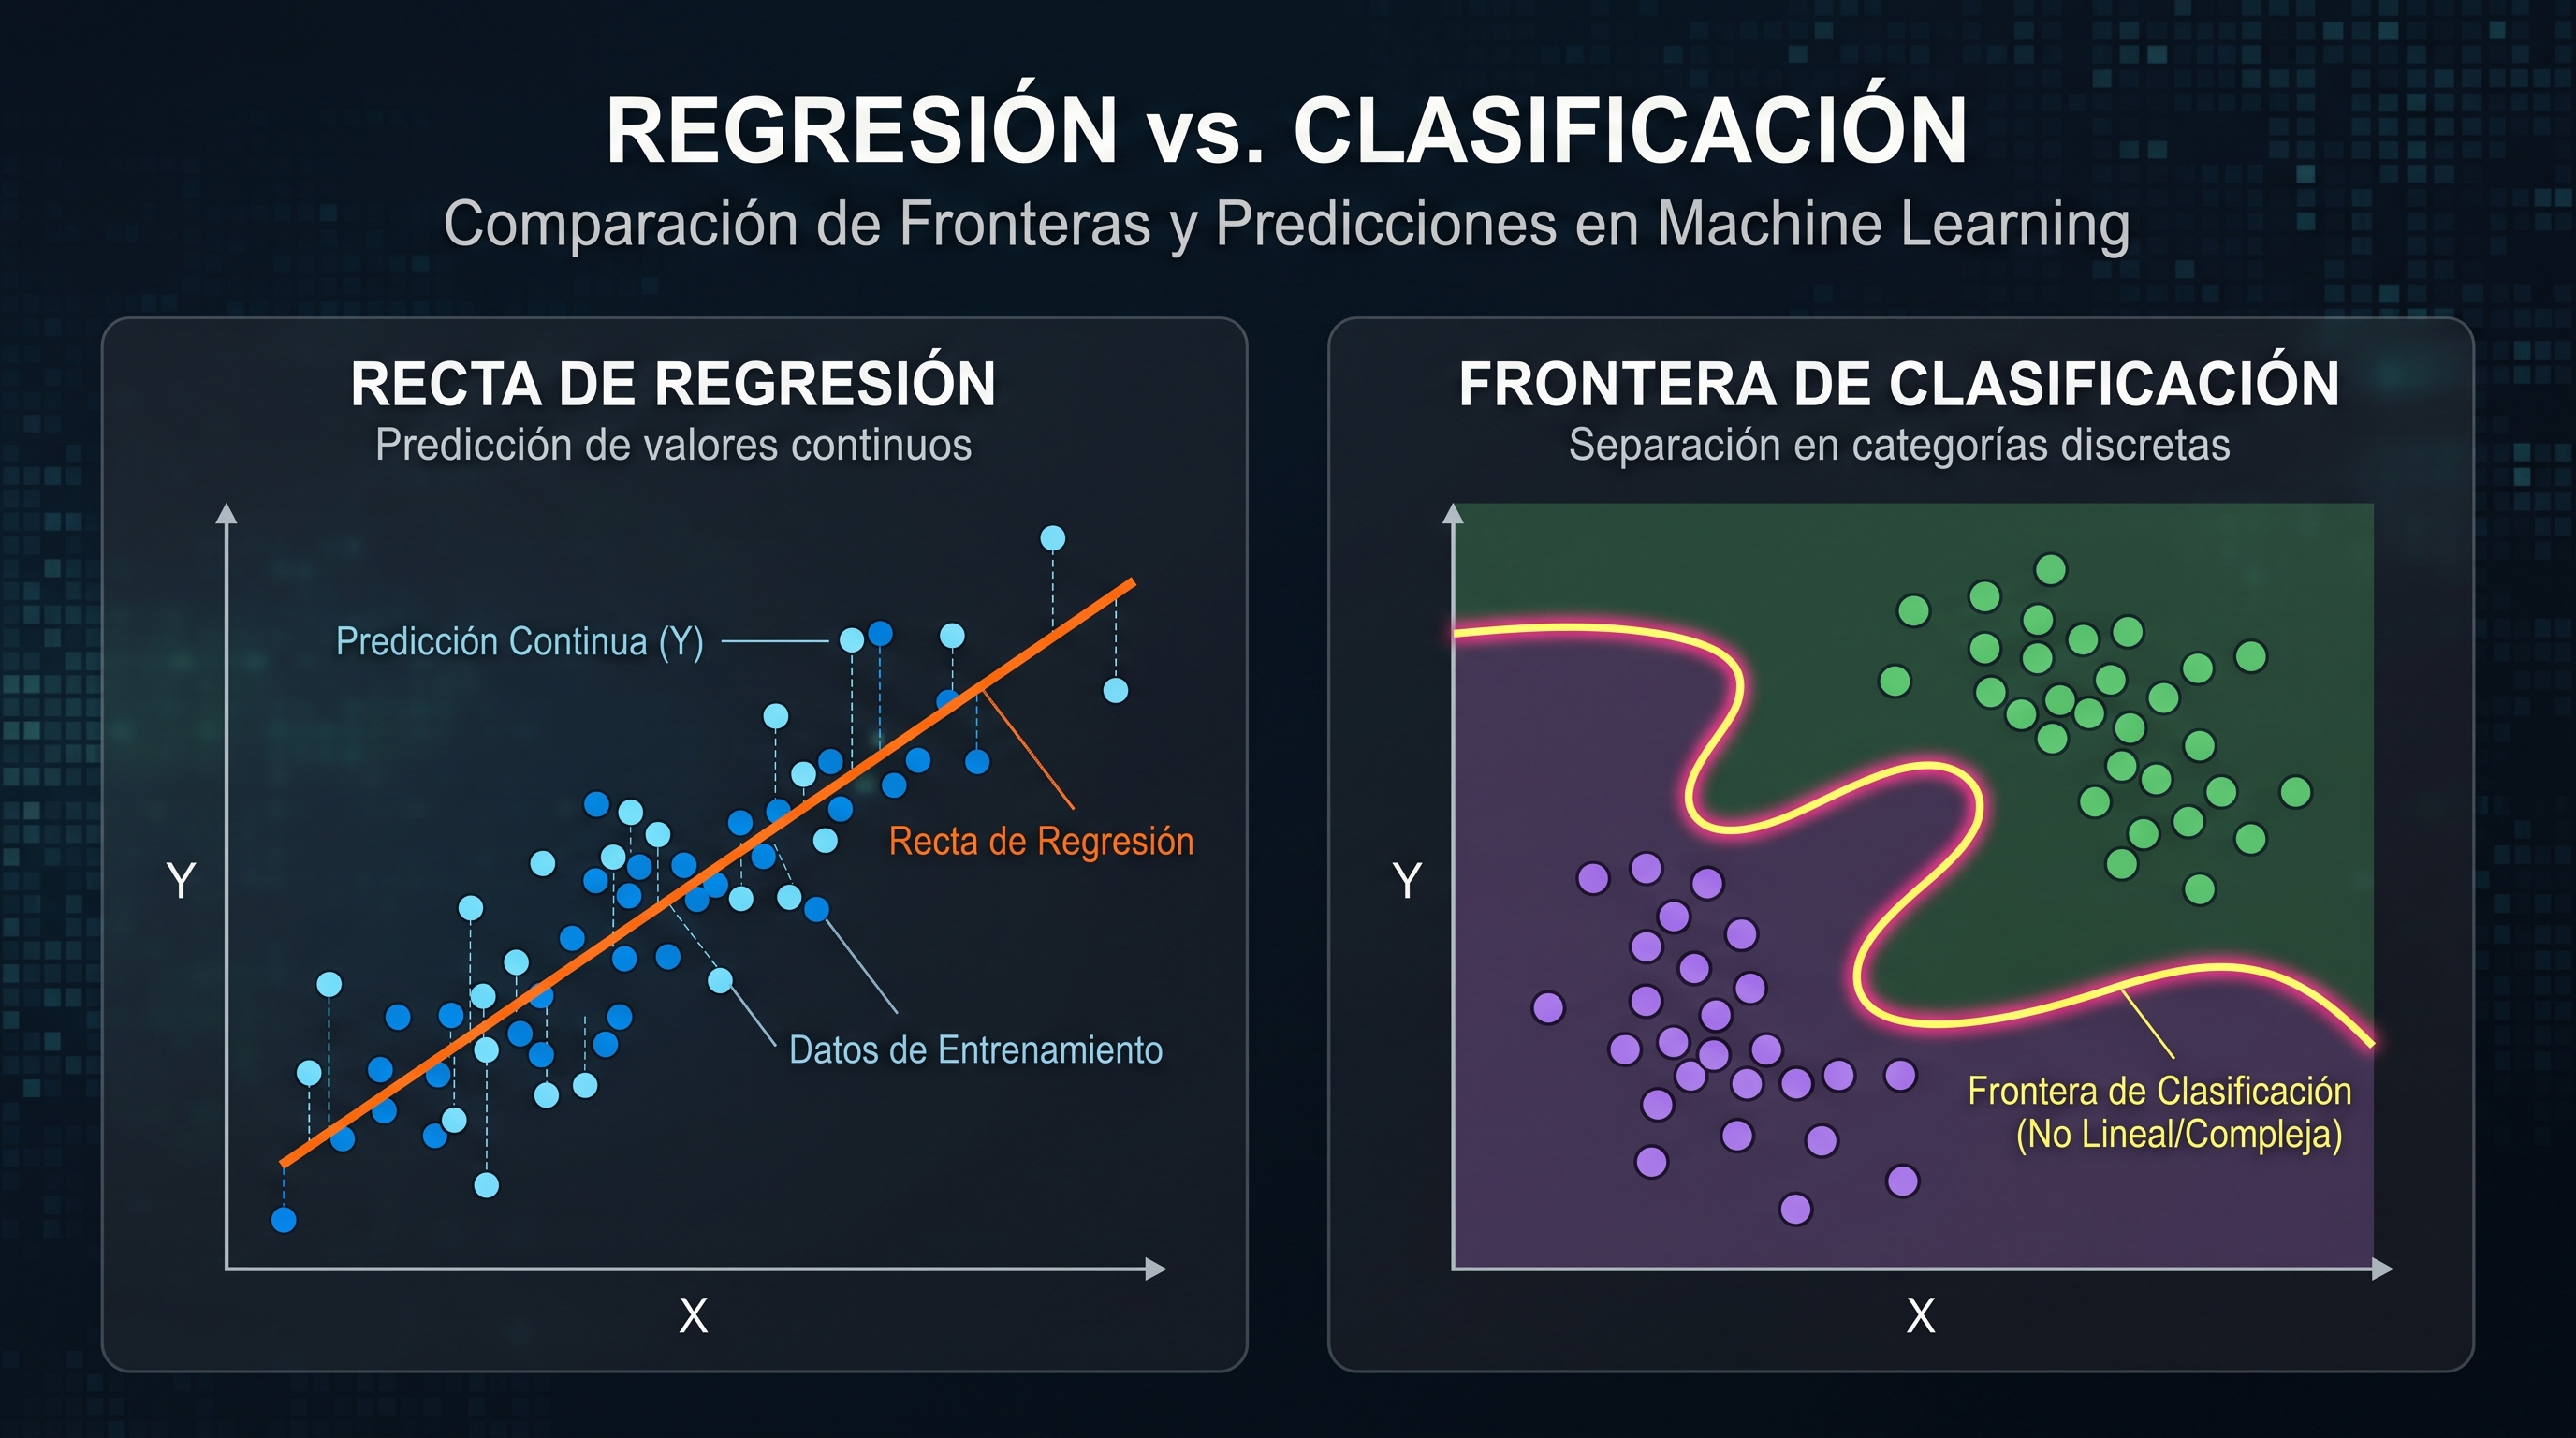
La regresión lineal modela la relación entre una variable dependiente y una o varias variables explicativas mediante combinación lineal; permite estimar la relación entre variables y construir modelos relativamente interpretables.
¿Para qué sirve?
Es adecuada para problemas como estimar precios, demanda, ingresos o consumo cuando existe una relación aproximadamente lineal entre las variables.
En momentos donde existen muchas variables o riesgo de colinealidad, pueden utilizarse variantes regularizadas como Ridge y Lasso, que incorporan penalizaciones para controlar la complejidad del modelo. (scikit-learn.org)
La principal ventaja es la interpretabilidad, la limitación aparece cuando las relaciones son fuertemente no lineales o existen interacciones que el modelo no representa adecuadamente.
Regresión logística y clasificación con probabilidades
Aunque su nombre contenga “regresión”, la regresión logística se utiliza principalmente para clasificación. Estima la probabilidad de pertenencia a una categoría mediante X función logística y puede extenderse a problemas multiclase.
¿Para qué sirve?
Es útil cuando necesitamos clasificar observaciones como fraude/no fraude, abandono/no abandono o aprobación/no aprobación.
Su carácter relativamente interpretable y la posibilidad de incorporar regularización explican que siga siendo un modelo de referencia. Scikit-learn ofrece actualmente diferentes estrategias de regularización y solucionadores para este algoritmo. (scikit-learn.org) Resulta especialmente valioso como modelo de referencia frente a alternativas más complejas.
Árboles de decisión. Las reglas que dividen los datos
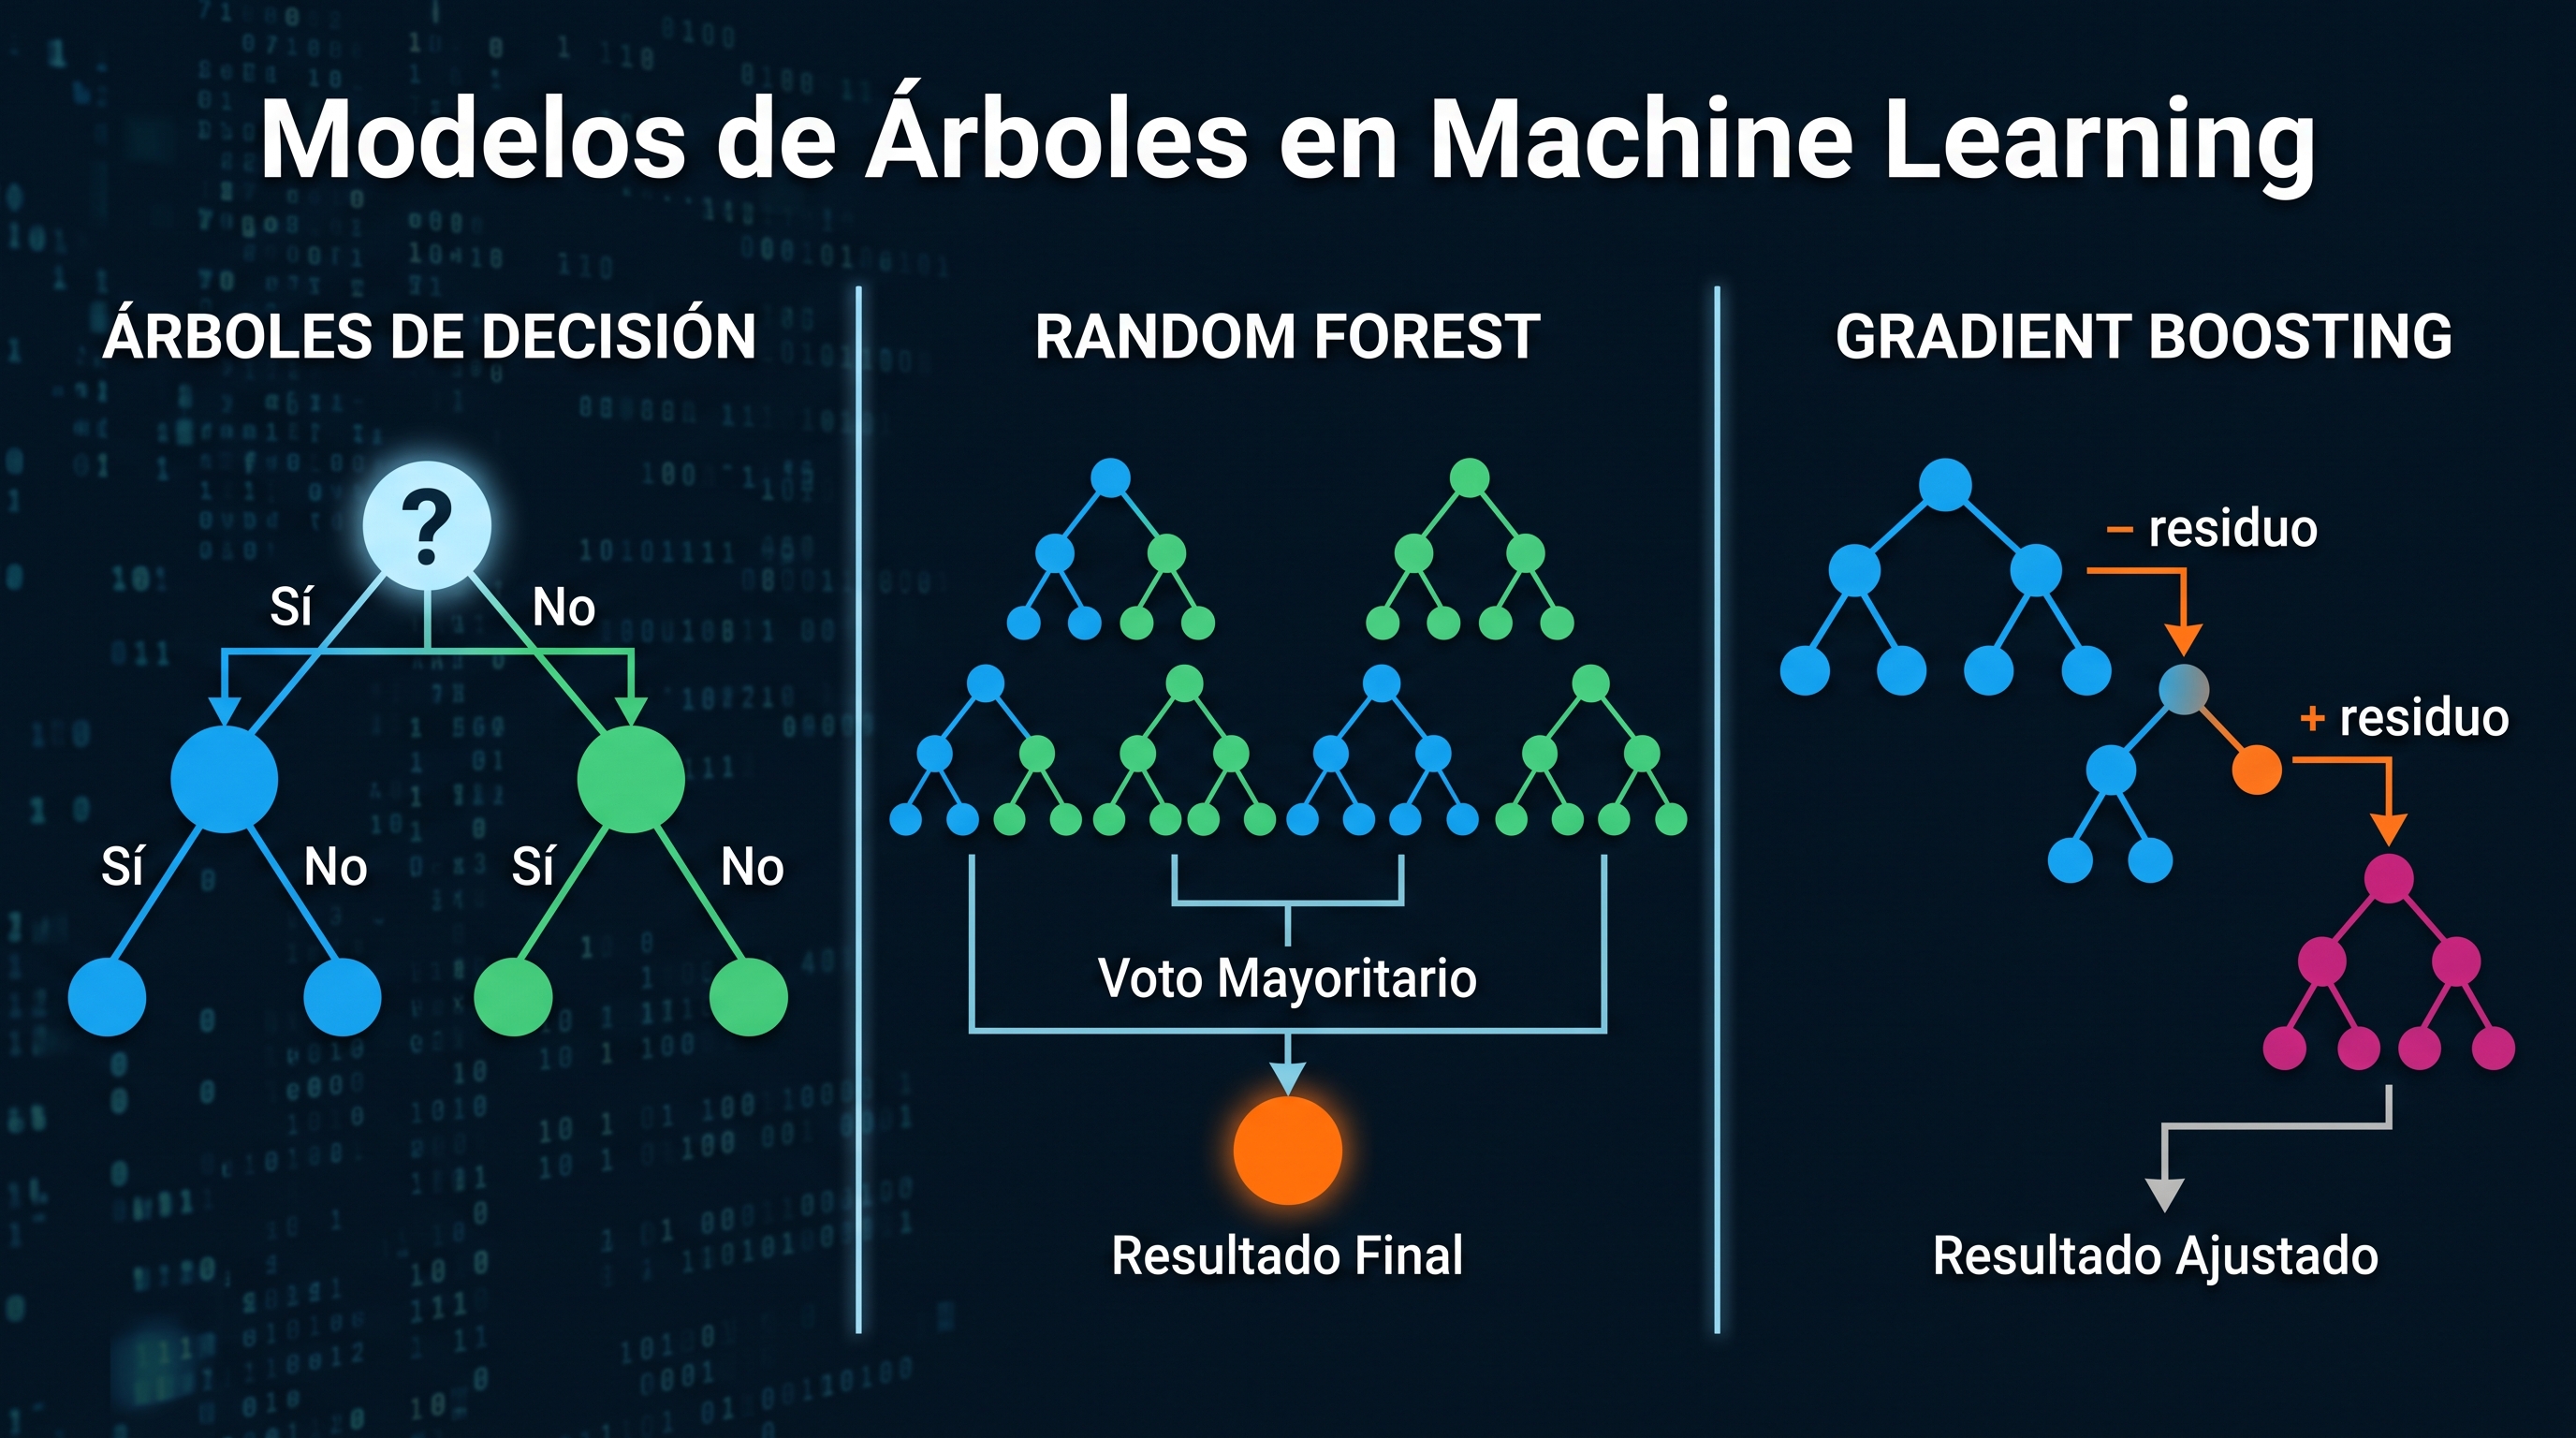
Los árboles de decisión construyen una secuencia de divisiones que conduce a una predicción. En cada nodo se seleccionan variables y puntos de corte según un criterio de partición.
¿Para qué sirven?
Pueden utilizarse tanto para clasificación como para regresión y son especialmente atractivos cuando necesitamos representar reglas de decisión de forma comprensible.
No obstante, un árbol demasiado profundo puede ajustarse excesivamente al conjunto de entrenamiento. Scikit-learn incorpora parámetros como profundidad máxima, número mínimo de observaciones por hoja y reducción mínima de impureza para controlar su complejidad. (scikit-learn.org)
Dentro de un proyecto de Data Science, el árbol suele ser también un instrumento útil para interpretar variables y construir una primera aproximación al problema.
Random Forest y combinar muchos árboles
Random Forest pertenece a los métodos de ensamblado. En lugar de depender de un único árbol, combina múltiples árboles construidos sobre distintas muestras y subconjuntos de variables.
¿Para qué sirve?
Es muy útil para clasificación y regresión, especialmente con datos tabulares y relaciones no lineales. El principal objetivo es obtener modelos más robustos que un árbol individual.
Los métodos de ensamblado combinan las predicciones de varios estimadores para mejorar la robustez o la capacidad de generalización. Random Forest y Gradient Boosting son dos de los ejemplos más conocidos. (scikit-learn.org)
Claro, el coste es una mayor complejidad y menor facilidad de interpretación que un único árbol.
Gradient Boosting para aprender de los errores anteriores
El Gradient Boosting construye una secuencia de modelos débiles, normalmente árboles, en la que cada nueva etapa intenta corregir los errores cometidos por las anteriores.
¿Para qué sirve?
Es uno de los enfoques más relevantes para clasificación y regresión sobre datos tabulares. La documentación de scikit-learn destaca específicamente los gradient-boosted trees como modelos adecuados para ambas tareas. (scikit-learn.org)
La capacidad predictiva puede ser elevada, pero requiere controlar hiperparámetros como número de estimadores, profundidad y tasa de aprendizaje. El riesgo de sobreajuste hace imprescindible la validación.
K-Nearest Neighbors para predecir a partir de casos similares
El algoritmo K-Nearest Neighbors (KNN) se basa en una idea más bien sencilla: para clasificar o estimar una observación, se estudian sus vecinos más próximos y se utiliza la información de esos casos.
¿Para qué sirve?
Puede emplearse tanto en clasificación como en regresión, resultando intuitivo cuando la proximidad entre observaciones tiene significado. La principal dificultad es que depende de la representación y de la métrica de distancia. En alta dimensionalidad, la noción de “vecino cercano” puede perder utilidad. Por supuesto, la predicción exige consultar los datos disponibles, lo que puede aumentar el coste computacional. (scikit-learn.org)
Support Vector Machines, separando con margen
Las Support Vector Machines (SVM) buscan construir una frontera que separe clases maximizando el margen entre ellas. Mediante kernels representan relaciones no lineales.
¿Para qué sirven?
Se utilizan en clasificación y regresión y pueden resultar útiles en datasets de tamaño moderado y espacios con muchas variables. Scikit-learn incluye actualmente SVC, SVR y variantes lineales.
El rendimiento depende de decisiones como el kernel, la regularización y la escala de las variables. Esto hace que el preprocesamiento resulte especialmente relevante.
Naive Bayes en clasificación probabilística
Los algoritmos Naive Bayes utilizan el teorema de Bayes y una hipótesis simplificadora de independencia condicional entre variables.
¿Para qué sirven?
Resultan especialmente útiles en clasificación rápida y en determinadas tareas de texto, donde pueden manejar representaciones de alta dimensionalidad de forma eficiente.
La principal limitación es claramente su supuesto de independencia, que no siempre refleja la estructura real de los datos. Aun así, el método continúa siendo una referencia importante por su simplicidad y velocidad.
K-means para encontrar grupos
En aprendizaje no supervisado, K-means busca dividir las observaciones en un número predefinido de grupos minimizando la variación interna respecto de sus centroides.
¿Para qué sirve?
Es apropiado para segmentación cuando los grupos presentan una geometría relativamente compacta y se conoce o puede estimarse el número de clusters.
Su principal limitación es que hay que especificar k y que funciona peor con agrupaciones alargadas, irregulares o de densidad diferente. Scikit-learn advierte además que la inercia utilizada por K-means presupone determinadas propiedades geométricas. (scikit-learn.org)
Por lo anterior, K-means es una herramienta exploratoria poderosa, pero sus resultados deben interpretarse y validarse en función del dominio.
DBSCAN para detectar densidades y anomalías
DBSCAN agrupa puntos según la densidad de observaciones y permite identificar elementos considerados ruido.
¿Para qué sirve?
Es especialmente útil cuando los clusters presentan formas irregulares, existen tamaños de grupo diferentes o se desea detectar observaciones aisladas. La documentación actual de scikit-learn lo sitúa entre los métodos indicados para geometrías no planas, tamaños desiguales y eliminación de outliers.
La dificultad reside en seleccionar adecuadamente parámetros relacionados con la vecindad y la densidad.
Clustering jerárquico para observar relaciones entre grupos
El clustering jerárquico o aglomerativo construye progresivamente una estructura de grupos que puede representarse mediante un dendrograma.
¿Para qué sirve?
Es interesante cuando necesitamos estudiar diferentes niveles de agrupación y no solo una partición final. Resultar útil en segmentación, análisis biológico o exploración de estructuras complejas.
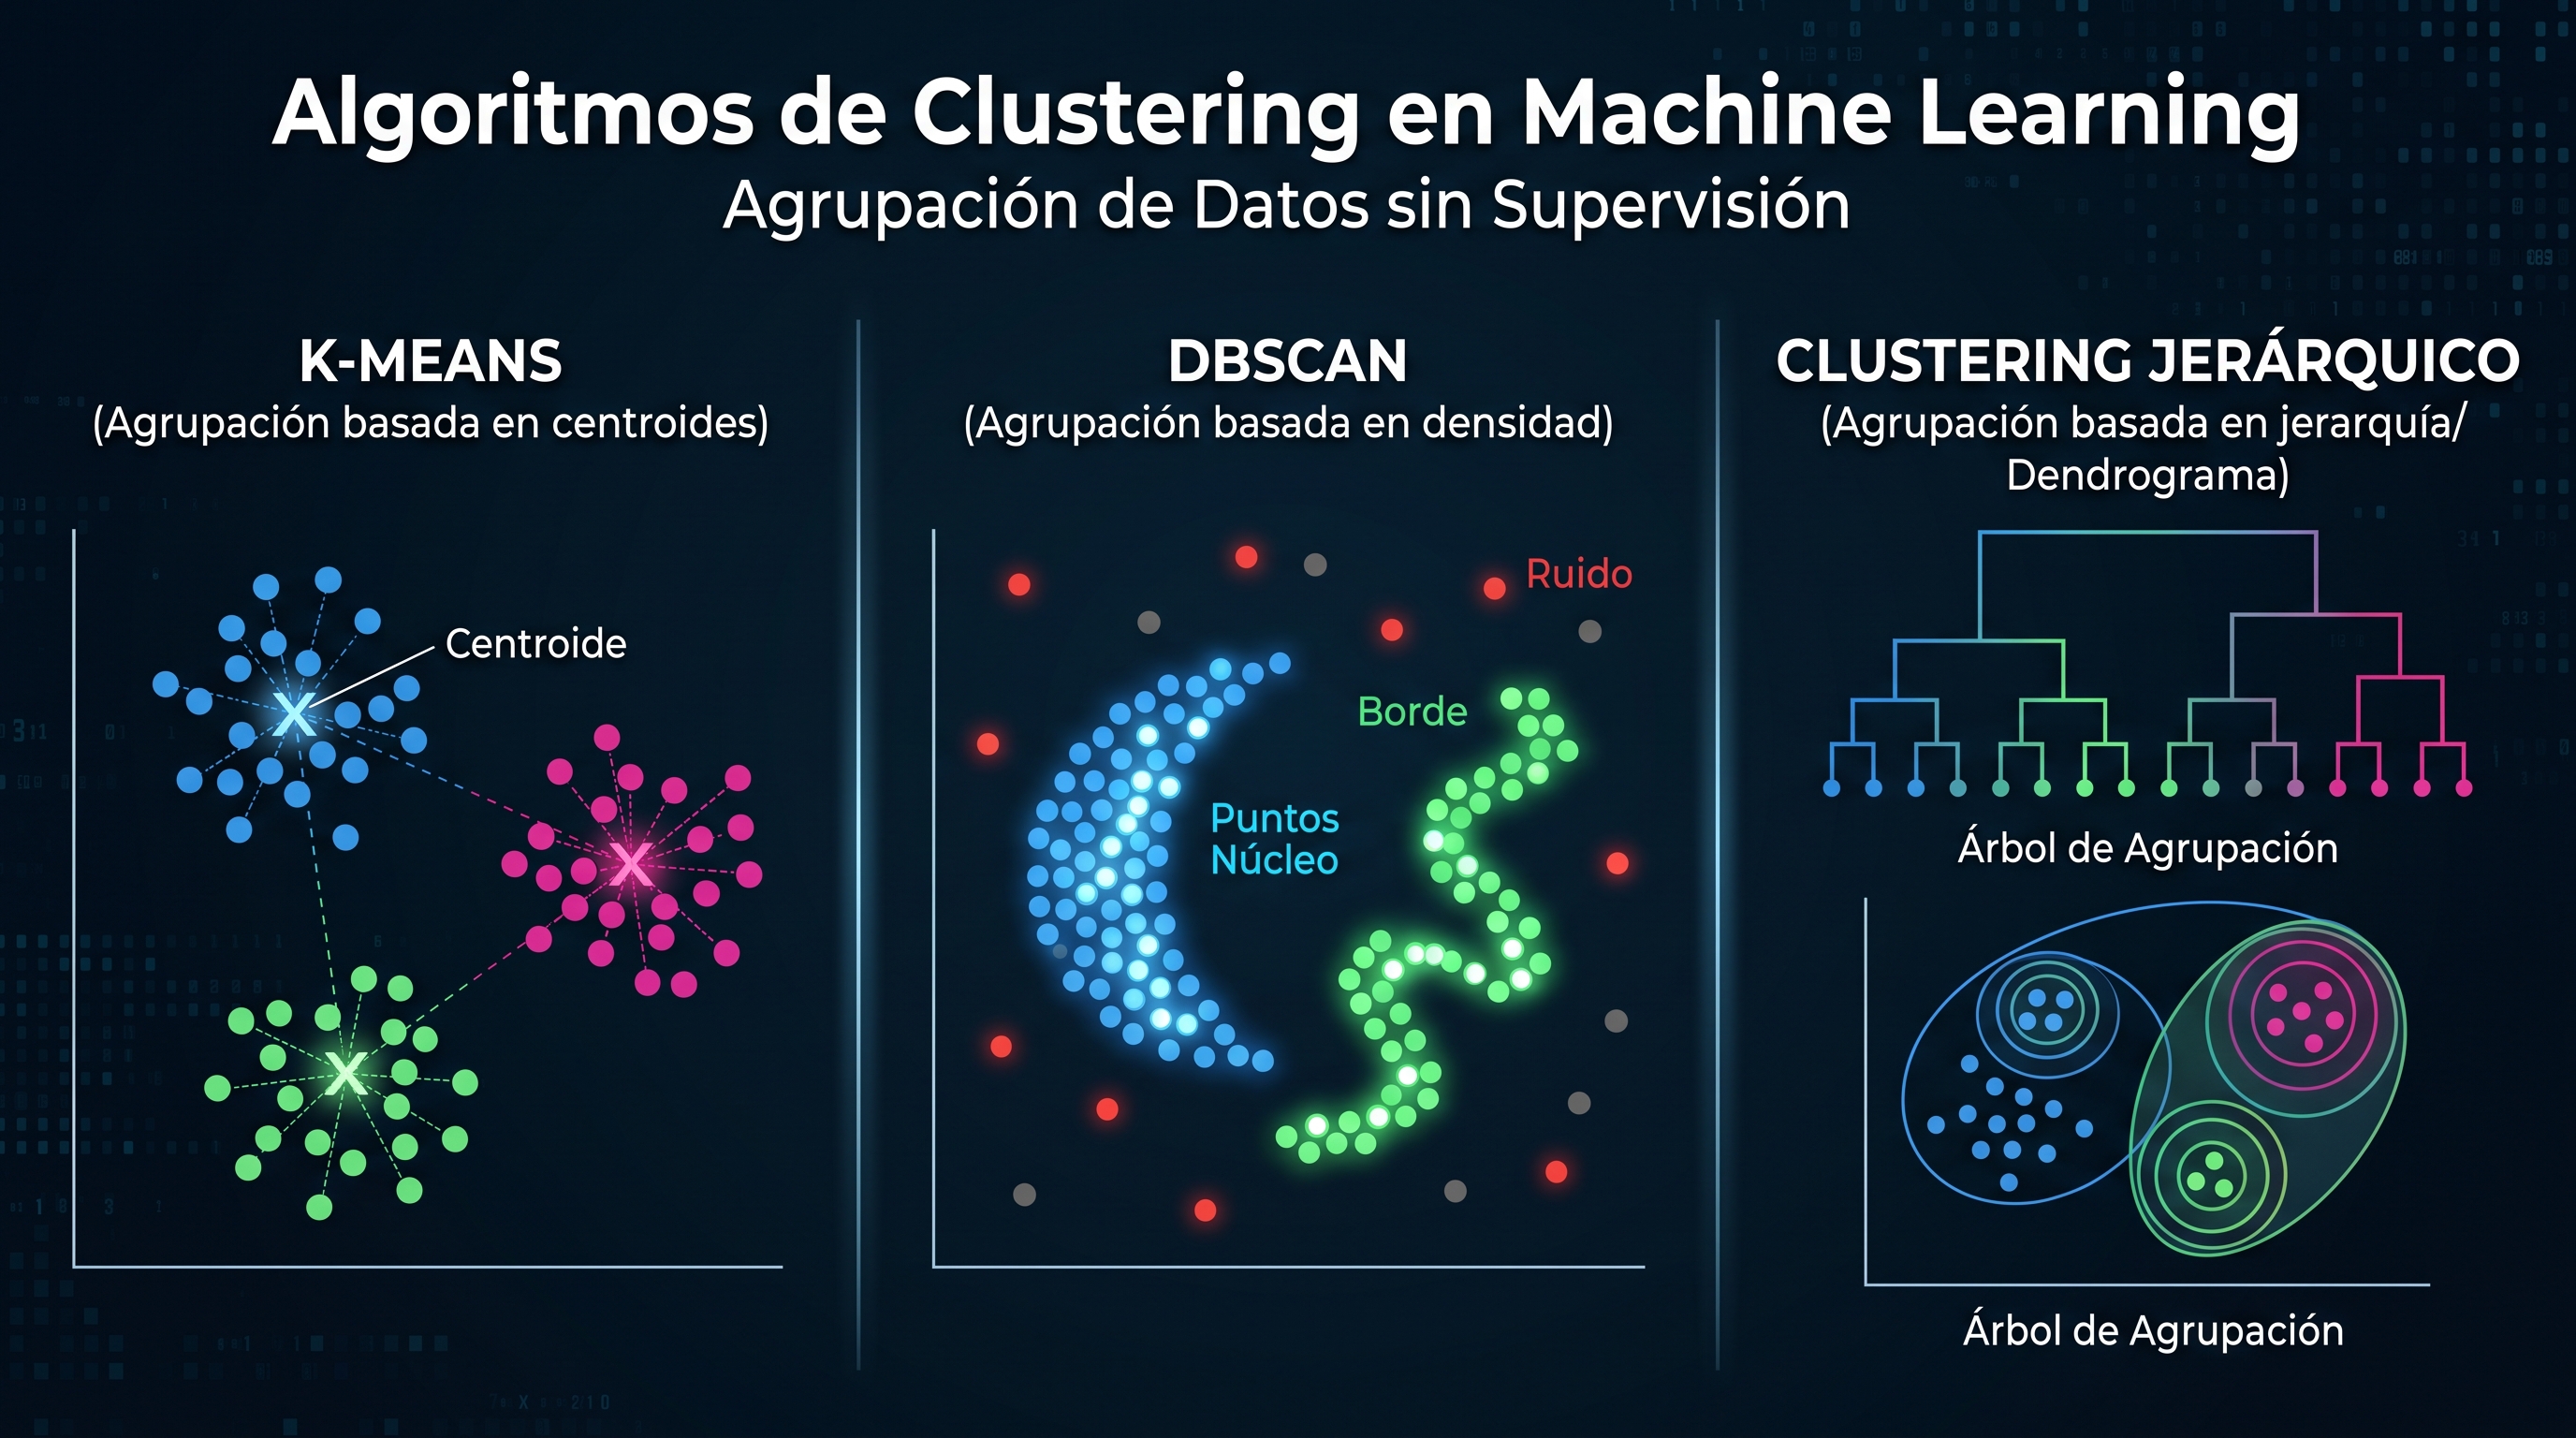
Scikit-learn contempla diferentes estrategias de linkage y permite utilizar restricciones de conectividad. La ventaja conceptual es mostrar una jerarquía, aunque coste computacional puede limitarlo en datasets muy grandes.
PCA para reducir dimensiones sin perder toda la información
El Análisis de Componentes Principales (PCA) no es un algoritmo predictivo convencional, sino una técnica de reducción de dimensionalidad.
¿Para qué sirve?
Permite representar múltiples variables mediante un número menor de componentes, facilitando visualización, compresión y, en ciertas situaciones, preprocesamiento para otros modelos.
La documentación de scikit-learn sitúa PCA dentro de los métodos de descomposición y reducción de dimensionalidad.
No obstante, reducir dimensiones implica perder parte de la información y puede dificultar la interpretación de las variables originales. Por esto, PCA debe emplearse con un objetivo analítico claro.
Redes neuronales para modelar relaciones complejas
Las redes neuronales artificiales utilizan capas de unidades conectadas para aprender funciones complejas; constituyen la base de buena parte del Deep Learning contemporáneo.
¿Para qué sirven?
Son especialmente importantes en imágenes, lenguaje, audio, series complejas y problemas donde las relaciones entre variables son difíciles de representar mediante modelos convencionales.
La potencia de esta solucióm tiene un coste: mayor demanda de datos y capacidad computacional, procesos de entrenamiento más complejos y dificultades adicionales de interpretación.
Por lo anterior, una red neuronal no debe considerarse automáticamente superior a un modelo tradicional. La decisión depende de la estructura del problema y de los recursos disponibles.
¿Cómo elegir entre algoritmos?
Como hemos explorado en artículos anteriores de esta Guía Data Science, la elección debería comenzar por el problema y los datos, no por el algoritmo de moda.
Para una variable continua puede plantearse regresión lineal, árboles, Random Forest o Gradient Boosting. Para clasificación podríamos comparar regresión logística, árboles, SVM, KNN o ensamblados. Cuando no existe etiqueta, K-means, DBSCAN o clustering jerárquico probar con responder a objetivos diferentes.
La comparación exige utilizar conjuntos de entrenamiento, validación y prueba, seleccionar métricas adecuadas y controlar el sobreajuste. La documentación de scikit-learn incorpora actualmente secciones específicas para validación cruzada, ajuste de hiperparámetros, métricas y selección de estimadores.
El principio fundamental es comparar modelos bajo las mismas condiciones y según la métrica relevante para el problema.
Algoritmos, escala y Big Data
La elección también cambia cuando el volumen crece. Un algoritmo X resulta, por ejemplo, apropiado con decenas de miles de observaciones, pero volverse poco eficiente cuando el problema alcanza millones o requiere actualización continua.
En estos contextos, la cuestión deja de ser exclusivamente estadística. Aparecen procesamiento distribuido, paralelismo, almacenamiento escalable y estrategias de entrenamiento sobre grandes conjuntos.
Esta dimensión forma parte de la relación entre Machine Learning y Big Data que aborda el Máster en Big Data y Data Science de la UNED. Su enfoque sobre Machine Learning a gran escala y computación distribuida permite entender que seleccionar un algoritmo implica considerar también cómo será ejecutado cuando la infraestructura deja de ser local. (masterbigdataonline.com)
De los algoritmos clásicos a los sistemas avanzados
Los algoritmos no existen de forma aislada. En un proyecto real se combinan mediante pipelines, ensamblados o procedimientos de selección automática. La literatura reciente sobre AutoML muestra una evolución hacia la automatización del diseño de pipelines, optimización de hiperparámetros y selección de modelos. (link.springer.com)
En paralelo, el desarrollo de Deep Learning ha ampliado las posibilidades de trabajar con texto, imágenes, audio y otros datos no estructurados.
El programa del Máster en Big Data y Data Science de la UNED contempla esta progresión hacia técnicas avanzadas mediante redes neuronales, CNN, RNN, autoencoders, modelos probabilísticos, aprendizaje por refuerzo y arquitecturas Transformer. La relevancia de estos contenidos no se apoya en acumular algoritmos, buscamos comprender qué problema matemático o computacional resuelve cada familia y cuándo su complejidad está justificada.
Una competencia esencial es saber cuándo no utilizar un algoritmo
Existe cierta tendencia a asociar el Machine Learning con modelos cada vez más complejos. Sin embargo, un buen análisis puede requerir exactamente lo contrario.
Un modelo lineal, por ejemplo, es suficiente si ofrece precisión adecuada y permite interpretar fácilmente sus resultados. El árbol ser preferible cuando la organización necesita reglas comprensibles. El ensamblado tener sentido si la prioridad es mejorar el rendimiento predictivo sobre datos tabulares. Y un modelo profundo adquiere mayor interés cuando el problema exige aprender representaciones complejas.
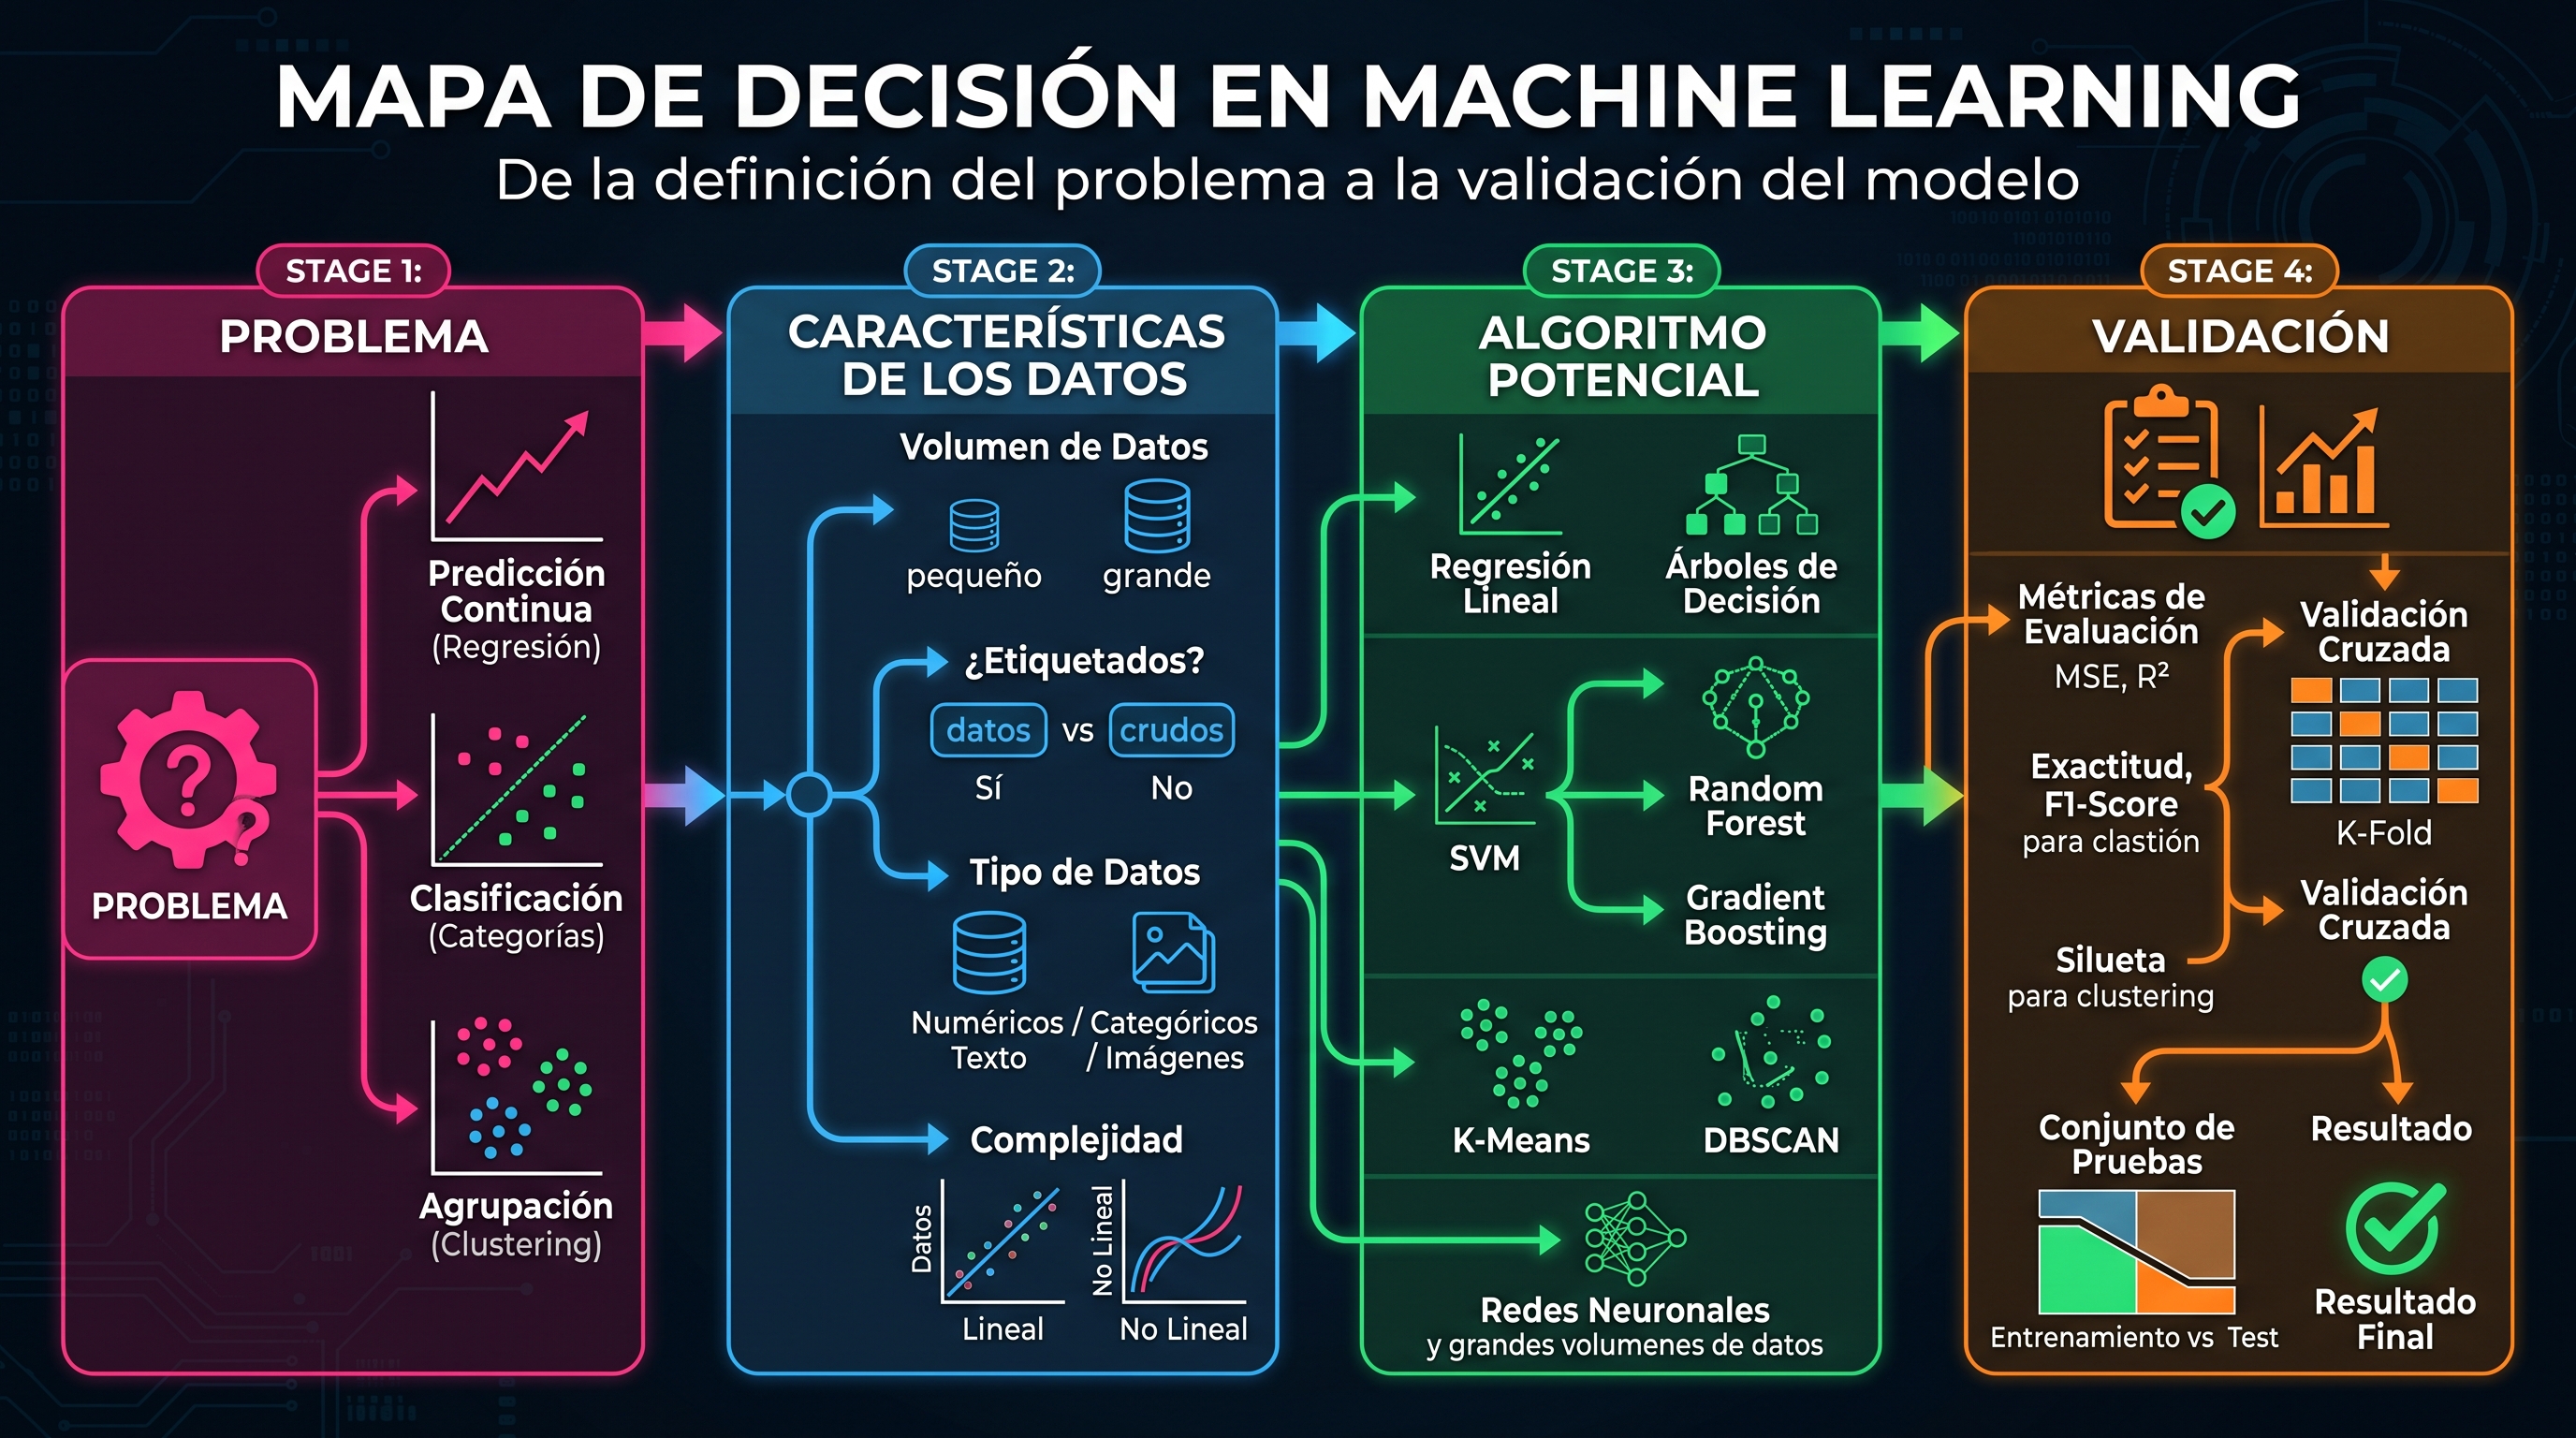
La decisión profesional pasa por encontrar el equilibrio entre precisión, coste, robustez, interpretabilidad y requisitos operativos.
Conclusiones
Los principales algoritmos de Machine Learning responden a problemas diferentes. Regresión lineal y logística ofrecen modelos relativamente interpretables. Árboles, Random Forest y Gradient Boosting permiten capturar relaciones no lineales. KNN y SVM abordan problemas desde la proximidad y la separación entre clases. Naive Bayes proporciona una aproximación probabilística eficiente. K-means, DBSCAN y clustering jerárquico permiten explorar estructuras sin etiquetas. PCA reduce dimensionalidad. Y las redes neuronales amplían la capacidad de modelización hacia problemas de mayor complejidad.
La elección no debería basarse exclusivamente en precisión. El modelo adecuado debe responder al objetivo, la estructura de los datos, coste computacional y a las consecuencias de sus errores.
Esta visión es especialmente importante en Data Science profesional. Conocer algoritmos se traduce en comprender sus supuestos, limitaciones y condiciones de uso. Cuando la escala aumenta, además, es necesario incorporar la infraestructura Big Data y considerar cómo se entrenará y ejecutará el modelo.
El Máster en Big Data y Data Science de la UNED aborda esta progresión desde los métodos estadísticos y la minería de datos hasta las técnicas avanzadas y el procesamiento a gran escala, proponiendo un sistema formativo en el que los algoritmos se estudian como herramientas para resolver problemas concretos.
En definitiva, dominar Machine Learning no es conocer el mayor número posible de algoritmos; es una trama tecnológica que va de saber formular el problema adecuado, seleccionar métodos justificables, compararlos rigurosamente y comprender sus consecuencias.
FAQ
¿Cuál es el algoritmo de Machine Learning más utilizado?
No existe un único algoritmo universalmente predominante. La elección depende del problema, los datos, la métrica y las restricciones operativas.
¿Qué algoritmo sirve para predecir valores numéricos?
La regresión lineal es una opción clásica, también pueden utilizarse árboles, Random Forest, Gradient Boosting, KNN o redes neuronales, dependiendo de la estructura del problema.
¿Qué algoritmo sirve para clasificar datos?
Entre las opciones más conocidas están regresión logística, árboles de decisión, Random Forest, Gradient Boosting, SVM, KNN y Naive Bayes.
¿Qué algoritmo se utiliza para segmentar clientes?
K-means es uno de los métodos más utilizados, aunque DBSCAN o el clustering jerárquico pueden resultar más adecuados según la geometría y densidad de los datos.
¿Qué diferencia existe entre Random Forest y Gradient Boosting?
Ambos combinan múltiples árboles, pero utilizan estrategias de ensamblado diferentes. Random Forest construye árboles de manera relativamente independiente, mientras Gradient Boosting los incorpora secuencialmente para reducir progresivamente el error.
¿Cuándo utilizar una red neuronal?
Cuando la complejidad del problema, el volumen de datos o la naturaleza de la información justifican un modelo de mayor capacidad, especialmente con imágenes, texto, audio o representaciones complejas.
¿Qué algoritmo funciona mejor con Big Data?
No existe una respuesta universal. La escalabilidad depende tanto del algoritmo como de la arquitectura, el volumen, la distribución de los datos y el método de entrenamiento.
¿Es necesario conocer muchos algoritmos para trabajar en Data Science?
Es más importante comprender en profundidad las principales familias, supuestos, fortalezas y limitaciones que memorizar una lista extensa de modelos.
Referencias bibliográficas
scikit-learn developers. (2026). scikit-learn 1.9.1 documentation. https://scikit-learn.org/stable/
scikit-learn developers. (2026). User guide. https://scikit-learn.org/stable/user_guide.html
scikit-learn developers. (2026). Decision trees. https://scikit-learn.org/stable/modules/tree.html
scikit-learn developers. (2026). Ensemble methods. https://scikit-learn.org/stable/modules/ensemble.html
scikit-learn developers. (2026). Support vector machines. https://scikit-learn.org/stable/modules/svm.html
scikit-learn developers. (2026). Naive Bayes. https://scikit-learn.org/stable/modules/naive_bayes.html
scikit-learn developers. (2026). Nearest neighbors. https://scikit-learn.org/stable/modules/neighbors.html
scikit-learn developers. (2026). Clustering. https://scikit-learn.org/stable/modules/clustering.html
scikit-learn developers. (2026). Decomposing signals in components and dimensionality reduction. https://scikit-learn.org/stable/api/sklearn.decomposition.html
Alcobaça, E., & de Carvalho, A. C. P. L. F. (2026). A literature review on automated machine learning. Artificial Intelligence Review, 59, 5. https://doi.org/10.1007/s10462-025-11397-2
Ramesh, K., Indrajith, M. N., Prasanna, Y. S., Deshmukh, S. S., Parimi, C., & Ray, T. (2025). Comparison and assessment of machine learning approaches in manufacturing applications. Industrial Artificial Intelligence, 3, 2. https://doi.org/10.1007/s44244-025-00023-3
Rezk, S. S., & Selim, K. S. (2024). Metaheuristic-based ensemble learning: An extensive review of methods and applications. Neural Computing and Applications, 36, 17931–17959. https://doi.org/10.1007/s00521-024-10203-4
Universidad Nacional de Educación a Distancia. (2026). Máster en Big Data y Data Science: contenido. https://www.masterbigdataonline.com/contenido.html
Universidad Nacional de Educación a Distancia. (2026). Máster en Big Data y Data Science: estructura y metodología. https://www.masterbigdataonline.com/estructura.html