Introducción
Guía Data Science - Deep Learning: El desarrollo del Deep Learning ha transformado el tratamiento computacional en dos formas fundamentales de información: las imágenes y el lenguaje. La capacidad de las redes neuronales profundas para aprender representaciones complejas ha ampliado las posibilidades de la visión artificial, el procesamiento del lenguaje natural y, más recientemente, los sistemas multimodales capaces de relacionar contenido visual y textual.
Esta evolución modifica cómo se construyen los sistemas analíticos. En lugar de diseñar manualmente todas las características relevantes, las arquitecturas profundas aprenden representaciones a partir de los datos y ajustan parámetros durante el entrenamiento. Una revisión publicada en 2025 sobre fundamentos del aprendizaje profundo examina precisamente esta evolución y sus aplicaciones en visión, lenguaje y otras tareas de inteligencia artificial (Tian et al., 2025). El progreso exige, sin embargo, una evaluación crítica. La capacidad de reconocer patrones no garantiza comprensión completa del contexto, así como un resultado técnicamente preciso durante el entrenamiento no asegura un comportamiento fiable ante datos diferentes. Por ello, aplicar Deep Learning a imágenes y lenguaje requiere integrar arquitectura, datos, evaluación y conocimiento del problema.
Cómo aprende Deep Learning a representar información
Las redes neuronales profundas organizan sucesivas transformaciones de los datos mediante capas de procesamiento. Durante el entrenamiento, los parámetros se ajustan para reducir una función de pérdida, utilizando procedimientos de optimización y retropropagación.
La arquitectura condiciona qué relaciones aprende el modelo. Las redes convolucionales explotan patrones espaciales, los Transformers utilizan mecanismos de atención para relacionar elementos de una secuencia y los modelos multimodales alinean representaciones procedentes de fuentes distintas.
Este principio amplía lo expuesto en el artículo Redes neuronales artificiales: qué son y cómo funcionan: aquí el interés se desplaza desde el mecanismo general de las neuronas hacia las decisiones arquitectónicas que permiten analizar imágenes, procesar lenguaje y combinar ambas modalidades.
Deep Learning aplicado a imágenes
Redes convolucionales y visión artificial
Las redes neuronales convolucionales (CNN) han ocupado una posición fundamental en la visión artificial. Sus filtros aprenden patrones locales que, al combinarse mediante sucesivas capas, permiten representar desde bordes y texturas hasta formas y objetos complejos.
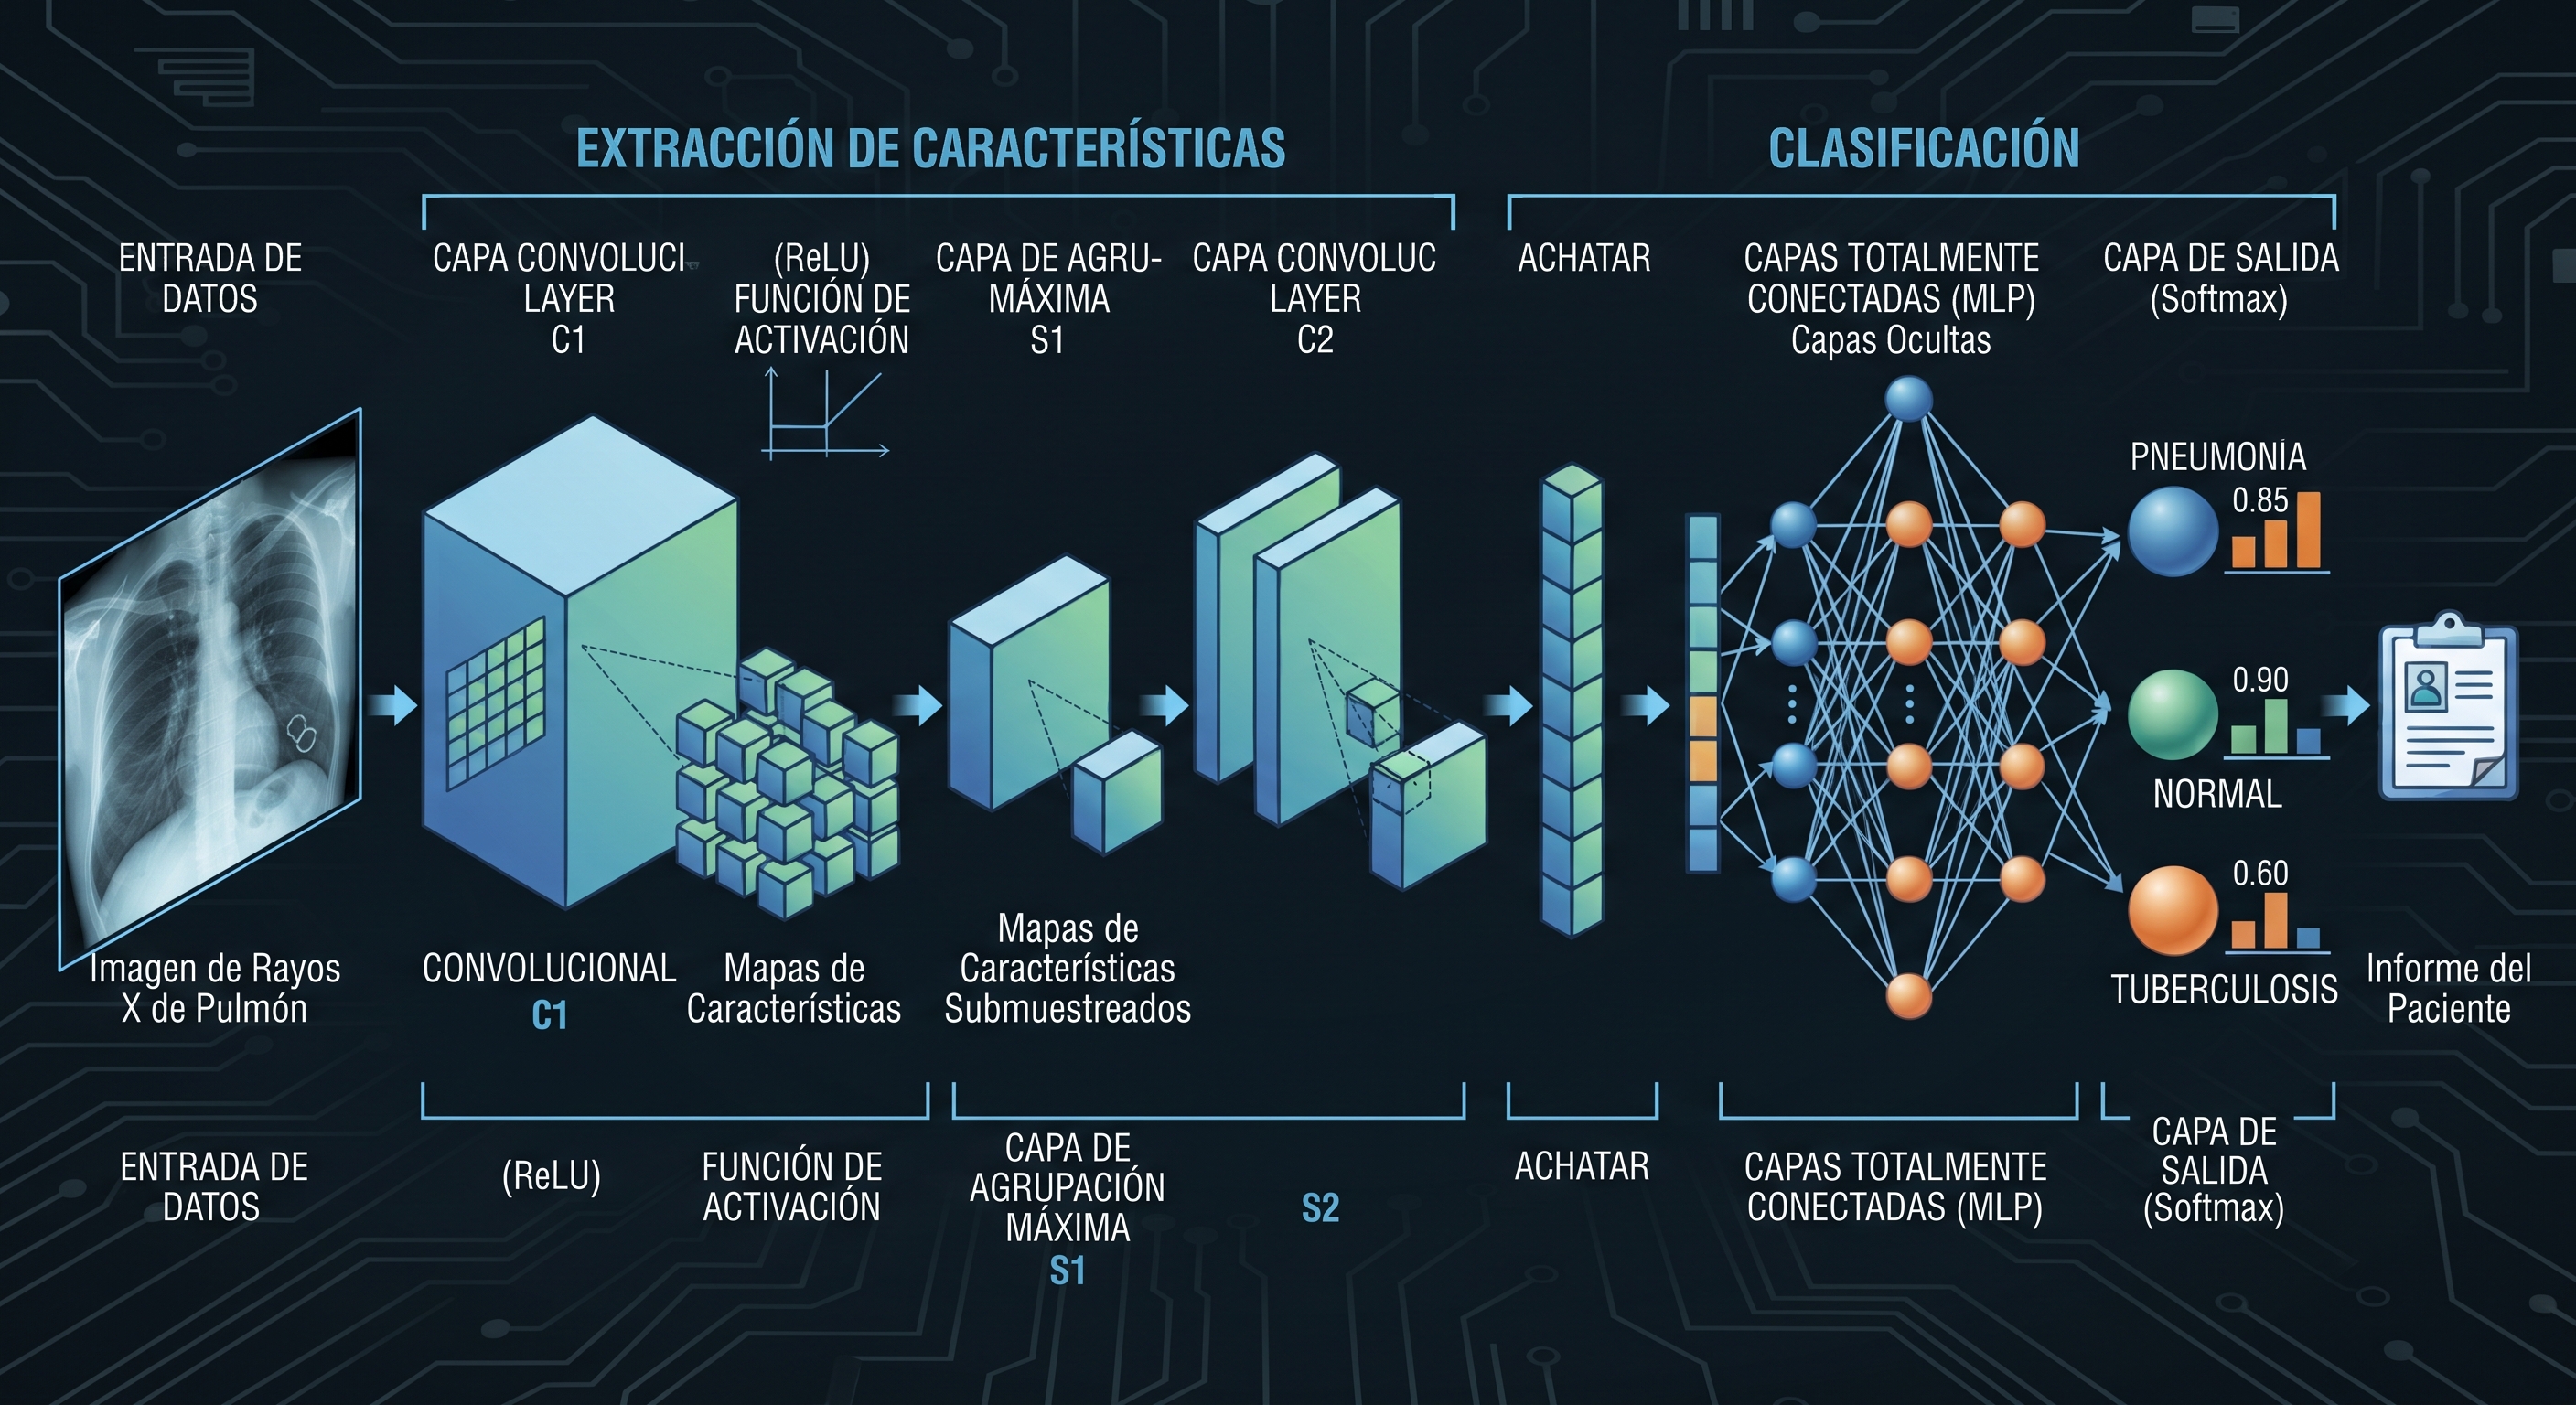
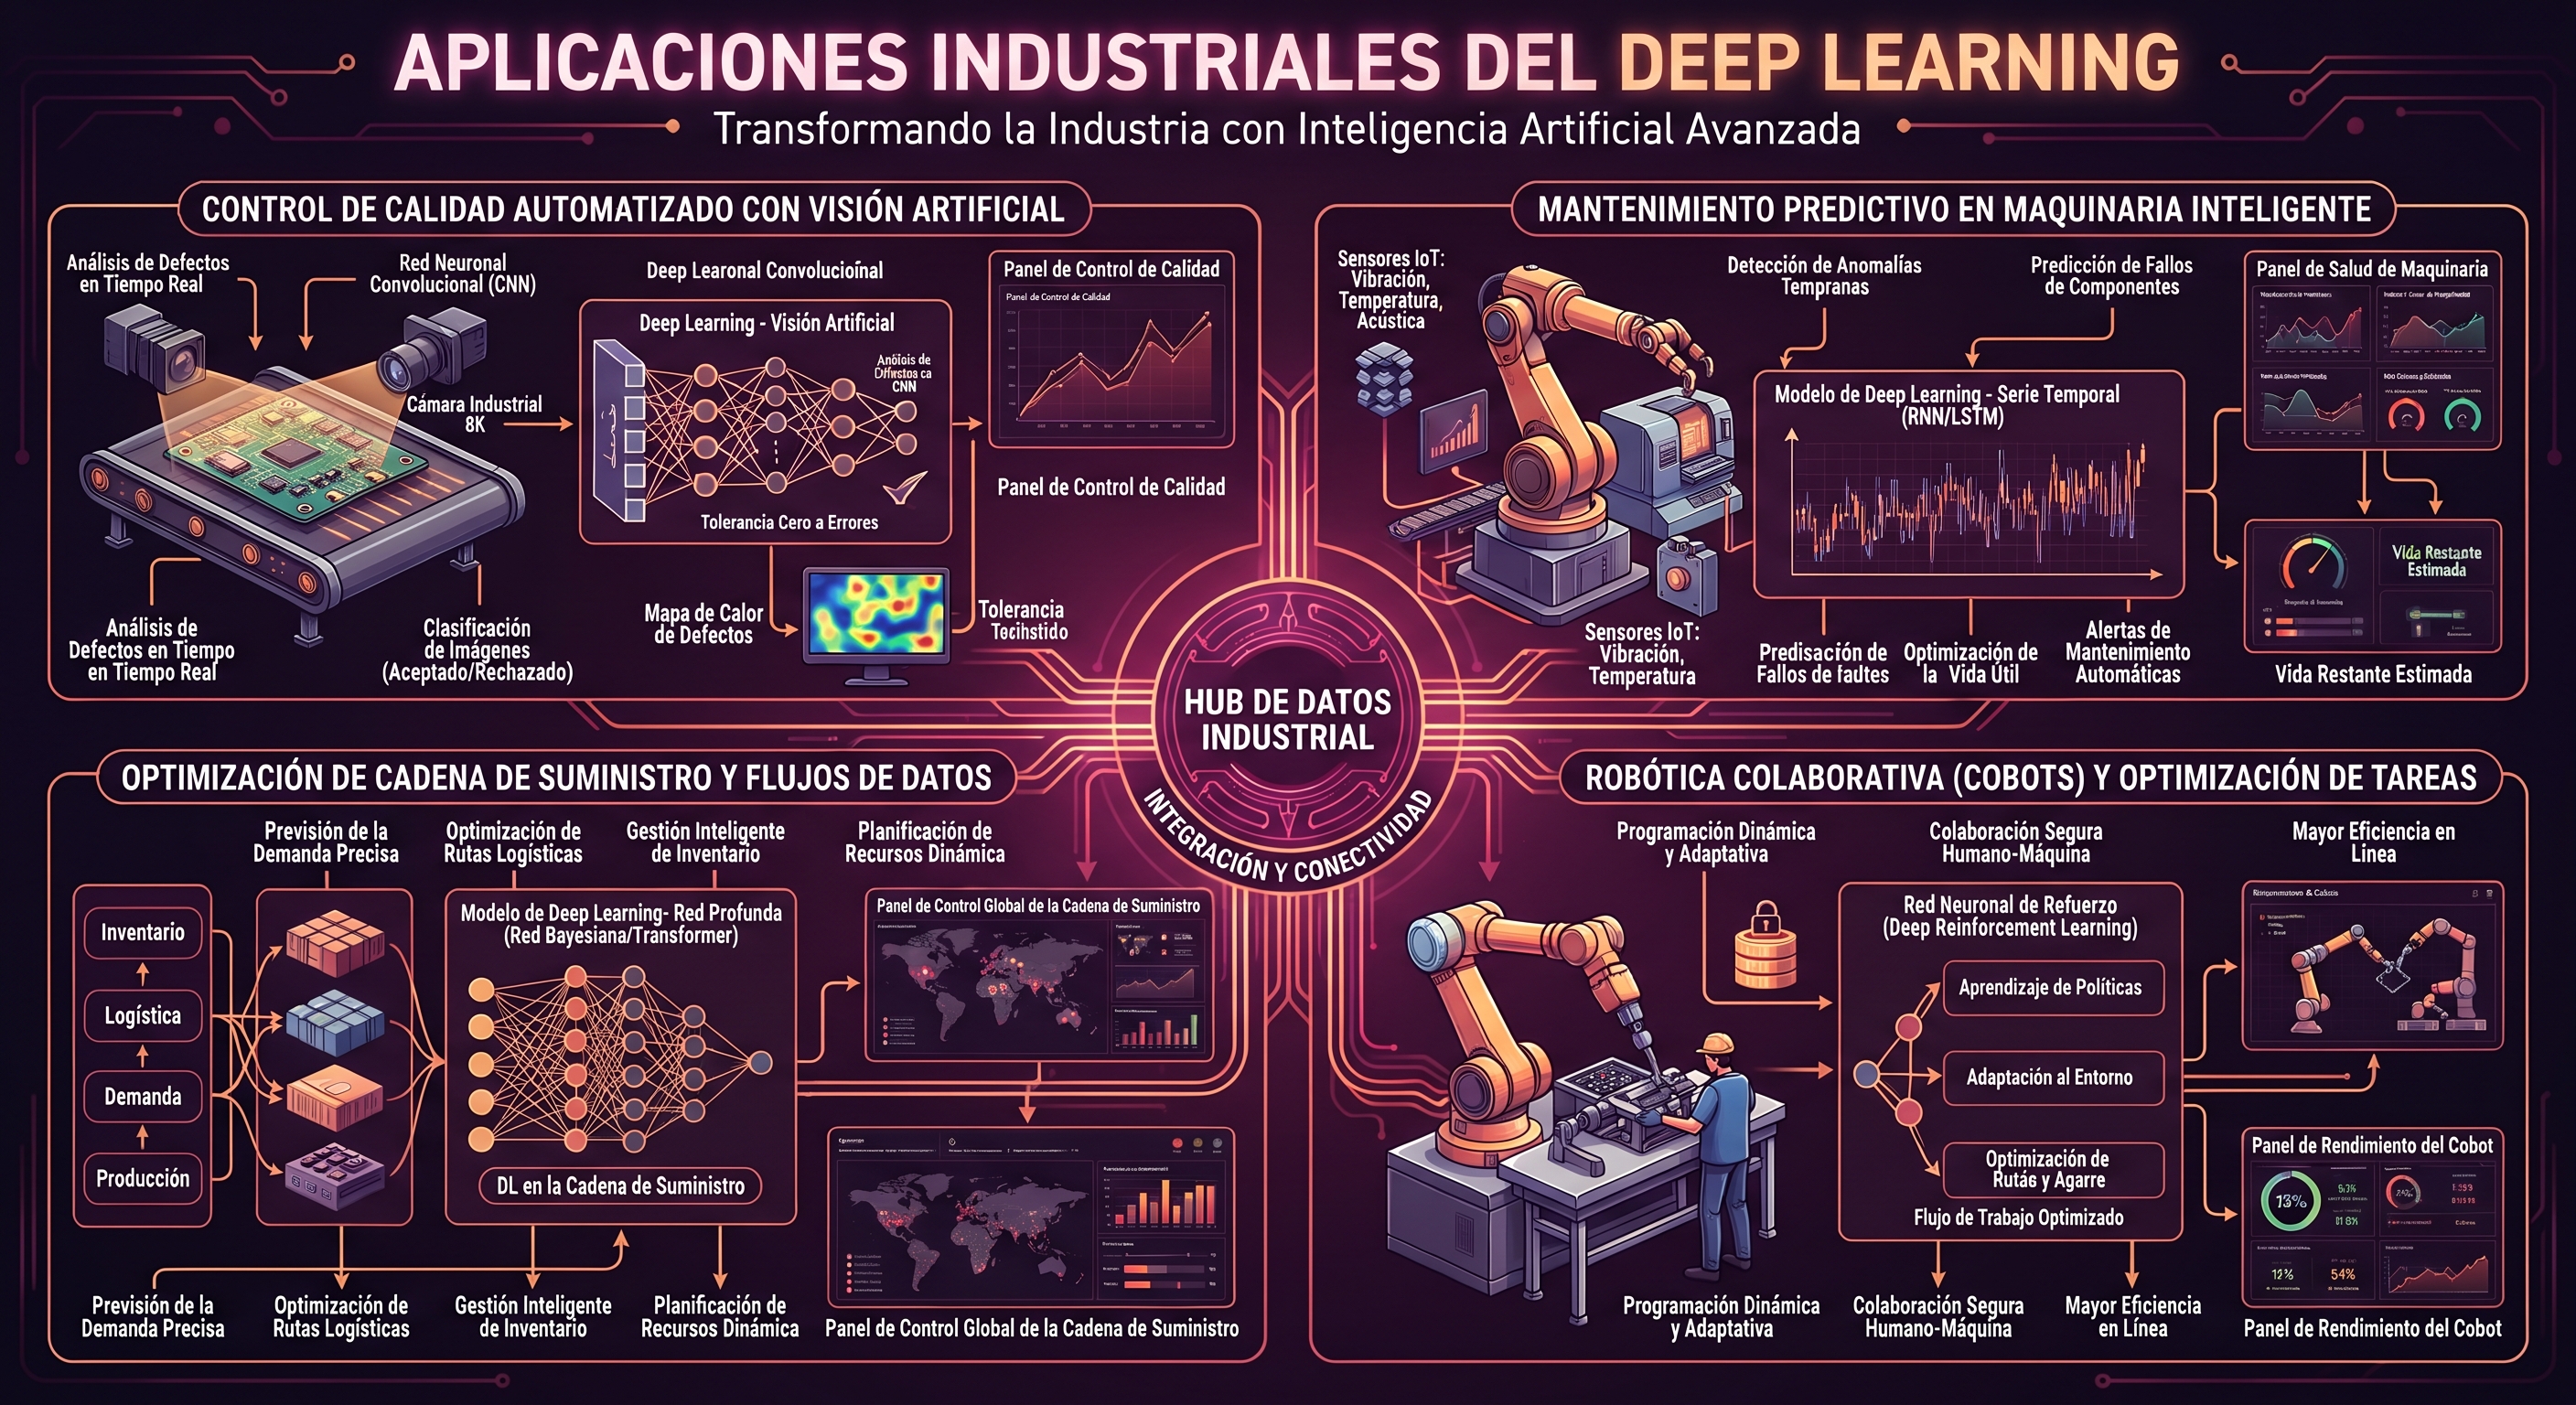
Entre las aplicaciones destacan la clasificación de imágenes, detección de objetos, segmentación e inspección automatizada. En la industria, estas técnicas permiten identificar defectos de fabricación, en agricultura analizar cultivos y en medicina estudiar radiografías, resonancias magnéticas y ecografías.
Una revisión publicada en 2025 en BMC Medical Imaging analizó 80 estudios sobre clasificación de imágenes médicas publicados entre 2014 y 2024. En la mitad de los trabajos, los conjuntos de datos contenían entre 1.000 y 10.000 muestras; además, el 54 % combinaba técnicas de preprocesamiento y aumento de datos. Estos resultados ilustran la importancia de preparar las imágenes, aunque no deben extrapolarse automáticamente a todos los ámbitos de la visión artificial (Laçi et al., 2025).
Vision Transformers y arquitecturas preentrenadas
Las CNN no constituyen la única alternativa. Los Vision Transformers adaptan la arquitectura Transformer al procesamiento de imágenes, dividiendo estas en fragmentos que se representan mediante vectores y se procesan con mecanismos de atención.
El interés de estas arquitecturas reside en las posibilidades para establecer relaciones entre regiones distantes de la imagen. La elección entre una CNN, un Vision Transformer u otro modelo depende de la tarea, el tamaño y la diversidad del conjunto de entrenamiento y los recursos computacionales disponibles.
El aprendizaje por transferencia añade otra posibilidad importante: partir de una arquitectura preentrenada y adaptarla a un problema específico. Esta estrategia resulta especialmente útil cuando reunir grandes cantidades de imágenes etiquetadas es costoso.
El programa del Máster en Big Data y Data Science de la UNED aborda estas técnicas en su módulo de Minería de Datos II, que incluye CNN y arquitecturas preentrenadas para tareas como la detección de objetos. Este contenido permite conectar los fundamentos matemáticos de las redes profundas con problemas concretos de visión artificial.
Deep Learning aplicado al lenguaje
De las representaciones textuales a los Transformers
El lenguaje presenta una dificultad diferente, el significado de una palabra depende de su contexto, posición y relaciones con otras expresiones.
Las primeras arquitecturas neuronales para secuencias incluyeron redes recurrentes y modelos como LSTM y GRU, diseñados para conservar información contextual a lo largo de una secuencia. Posteriormente, los Transformers introdujeron un mecanismo de atención que permite modelar relaciones entre distintas posiciones sin procesarlas necesariamente de forma recurrente.
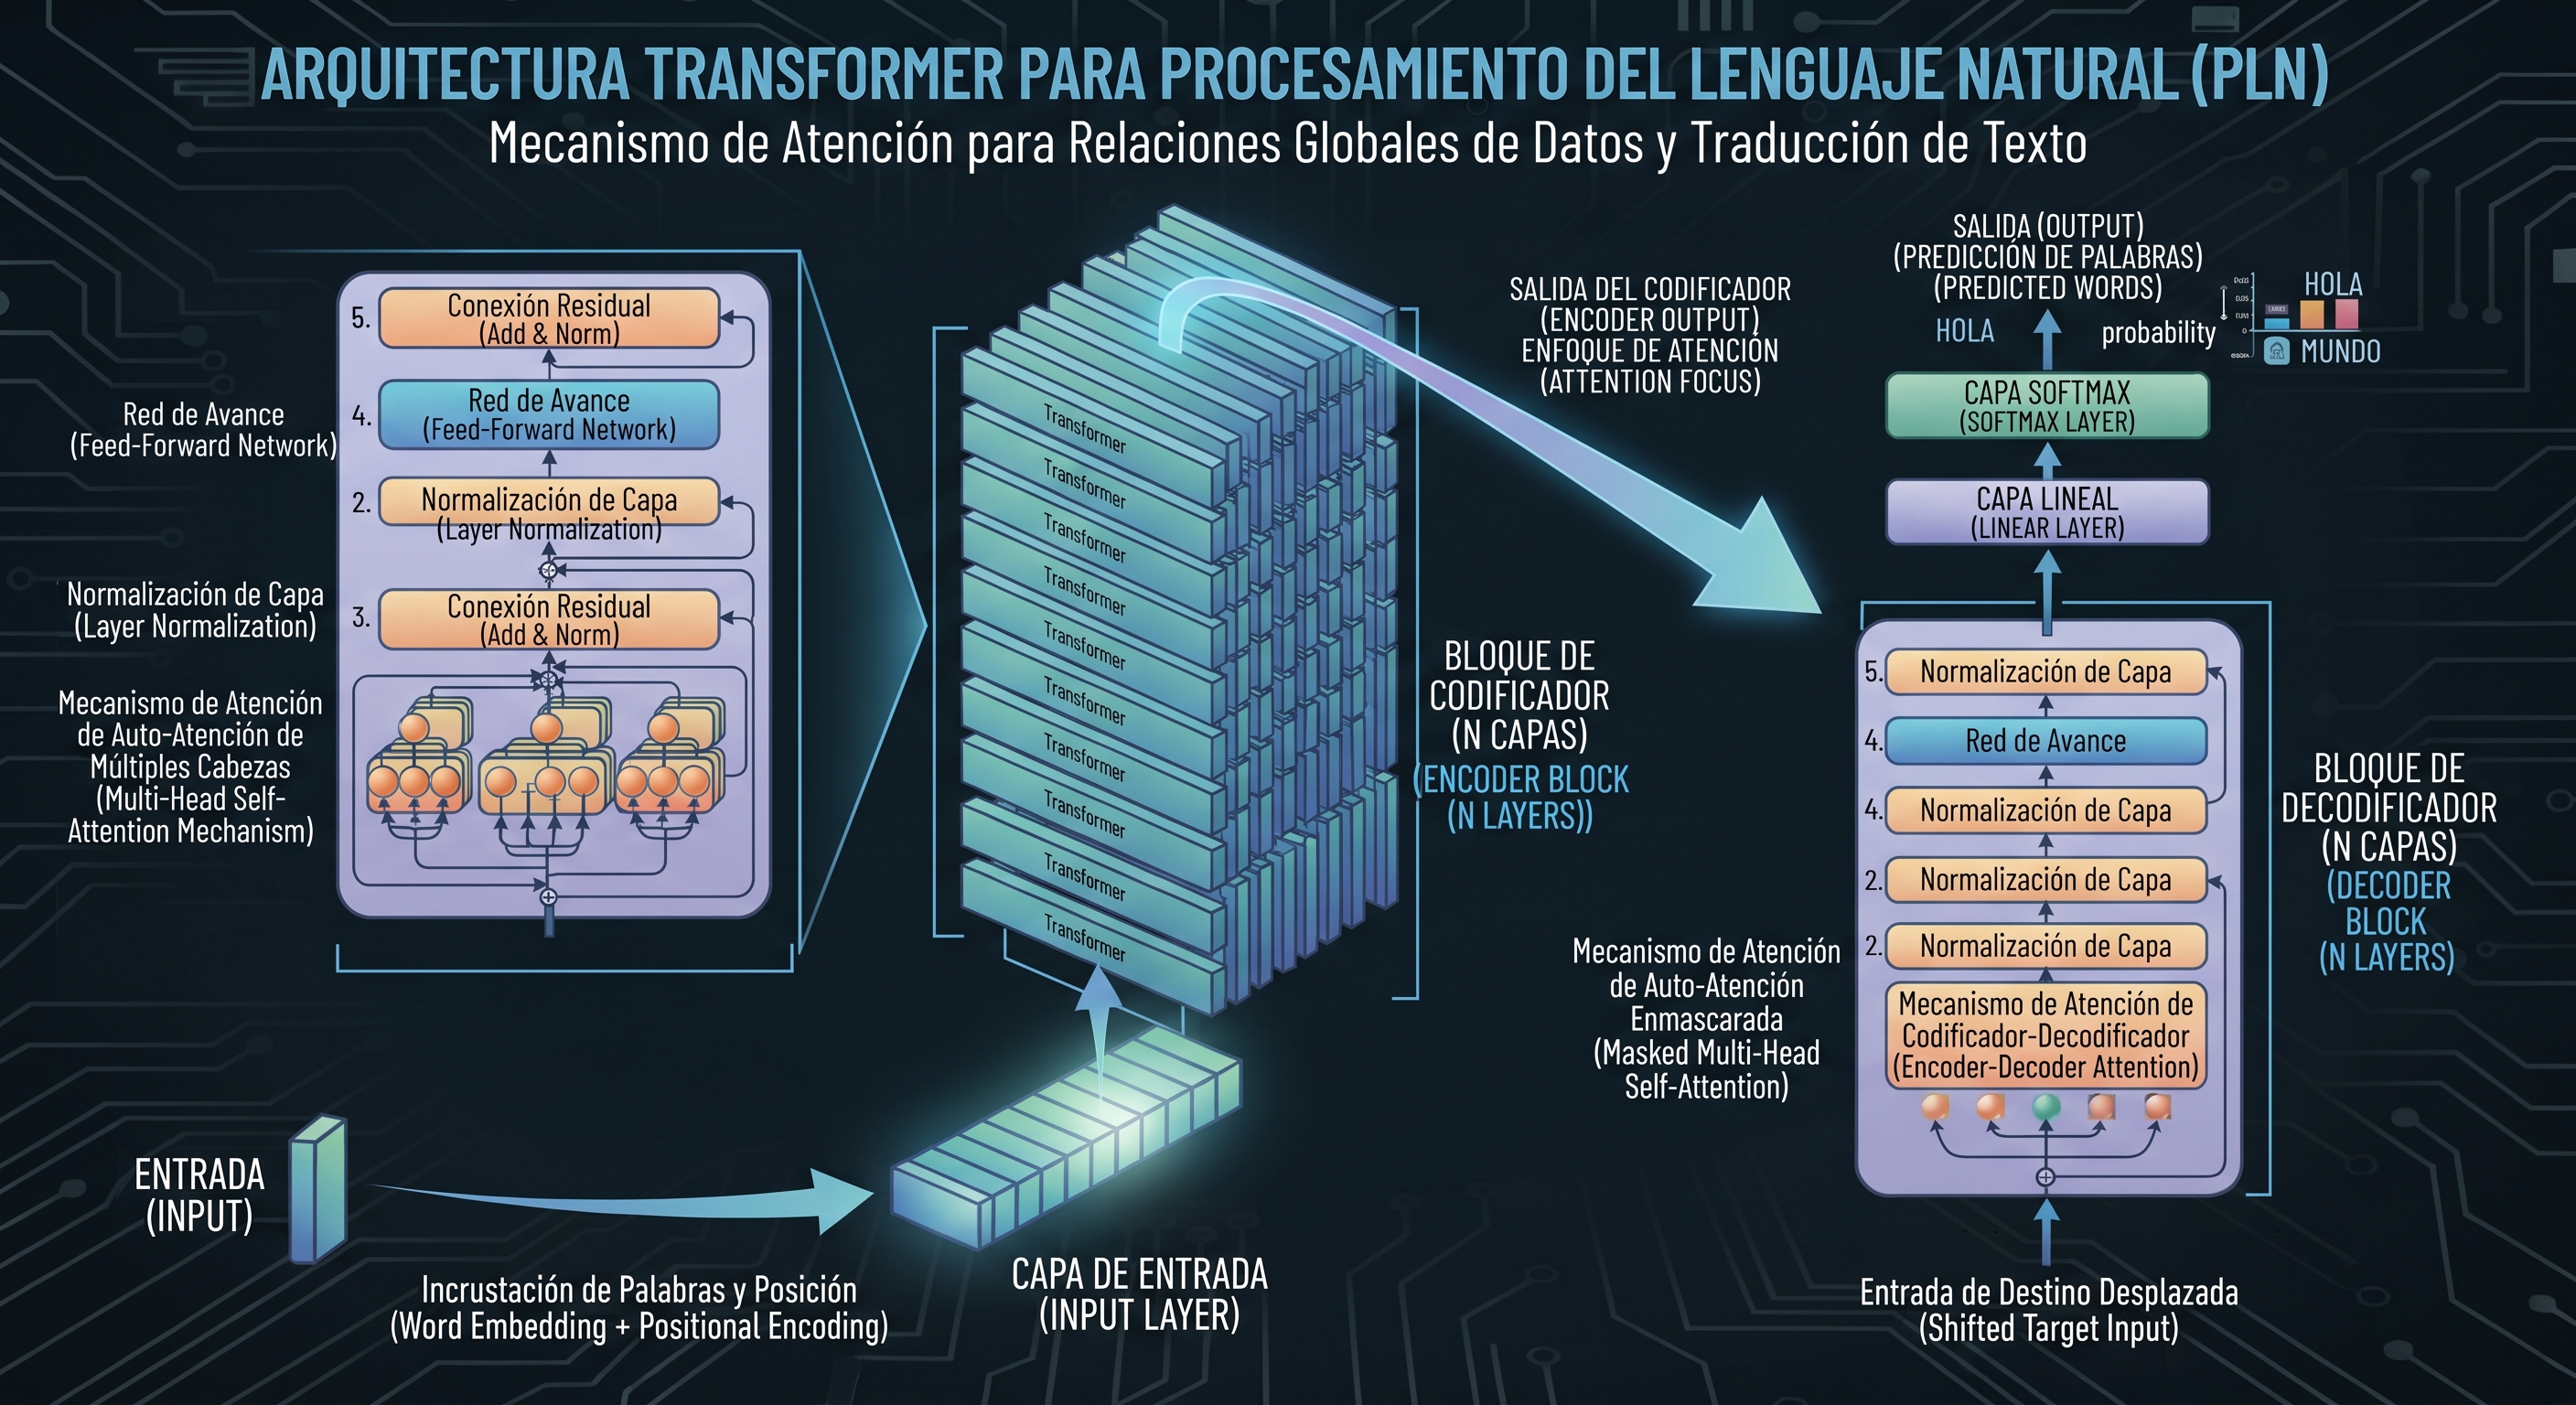
Esta arquitectura constituye una base esencial de numerosos modelos lingüísticos contemporáneos. Los grandes modelos de lenguaje se entrenan sobre extensos corpus textuales y adaptan mediante diferentes estrategias para tareas específicas. Una revisión publicada en 2026 analiza su evolución dentro del procesamiento del lenguaje natural, distinguiendo, entre otros enfoques, la utilización de modelos sin modificar sus parámetros y las estrategias que sí los ajustan (Qin et al., 2026).
Principales aplicaciones lingüísticas
El Deep Learning aplicado al lenguaje permite desarrollar sistemas para clasificación documental, análisis de sentimiento, traducción automática, extracción de entidades, resumen, búsqueda semántica y generación de texto.
En el ámbito empresarial, estas técnicas ayudan a analizar opiniones de clientes, procesar contratos, organizar documentación y detectar temas recurrentes en grandes colecciones de mensajes. En investigación, facilitan la exploración de literatura científica y la extracción de información de publicaciones especializadas.
Esta dimensión enlaza con el artículo anterior IA generativa aplicada al análisis de datos. Mientras aquella pieza se centraba en la integración de los modelos generativos en los procesos analíticos, aquí examinamos la base arquitectónica que hace posible buena parte de esas aplicaciones.
El módulo de Text Mining y Web Mining del Máster en Big Data y Data Science de la UNED incluye representaciones vectoriales, Transformers y grandes modelos de lenguaje, además de tareas como clasificación textual, análisis de sentimiento, búsqueda semántica y reconocimiento de entidades. La conexión es relevante porque trabajar con tal contenido exige tanto comprender los modelos como conocer la estructura lingüística y los criterios de evaluación adecuados.
Modelos multimodales. Conectar imágenes y lenguaje
Una de las líneas más importantes de investigación consiste en desarrollar modelos capaces de procesar conjuntamente información visual y textual. Los modelos visión-lenguaje, conocidos como Vision-Language Models (VLM), permiten relacionar imágenes con descripciones y preguntas expresadas mediante lenguaje natural.
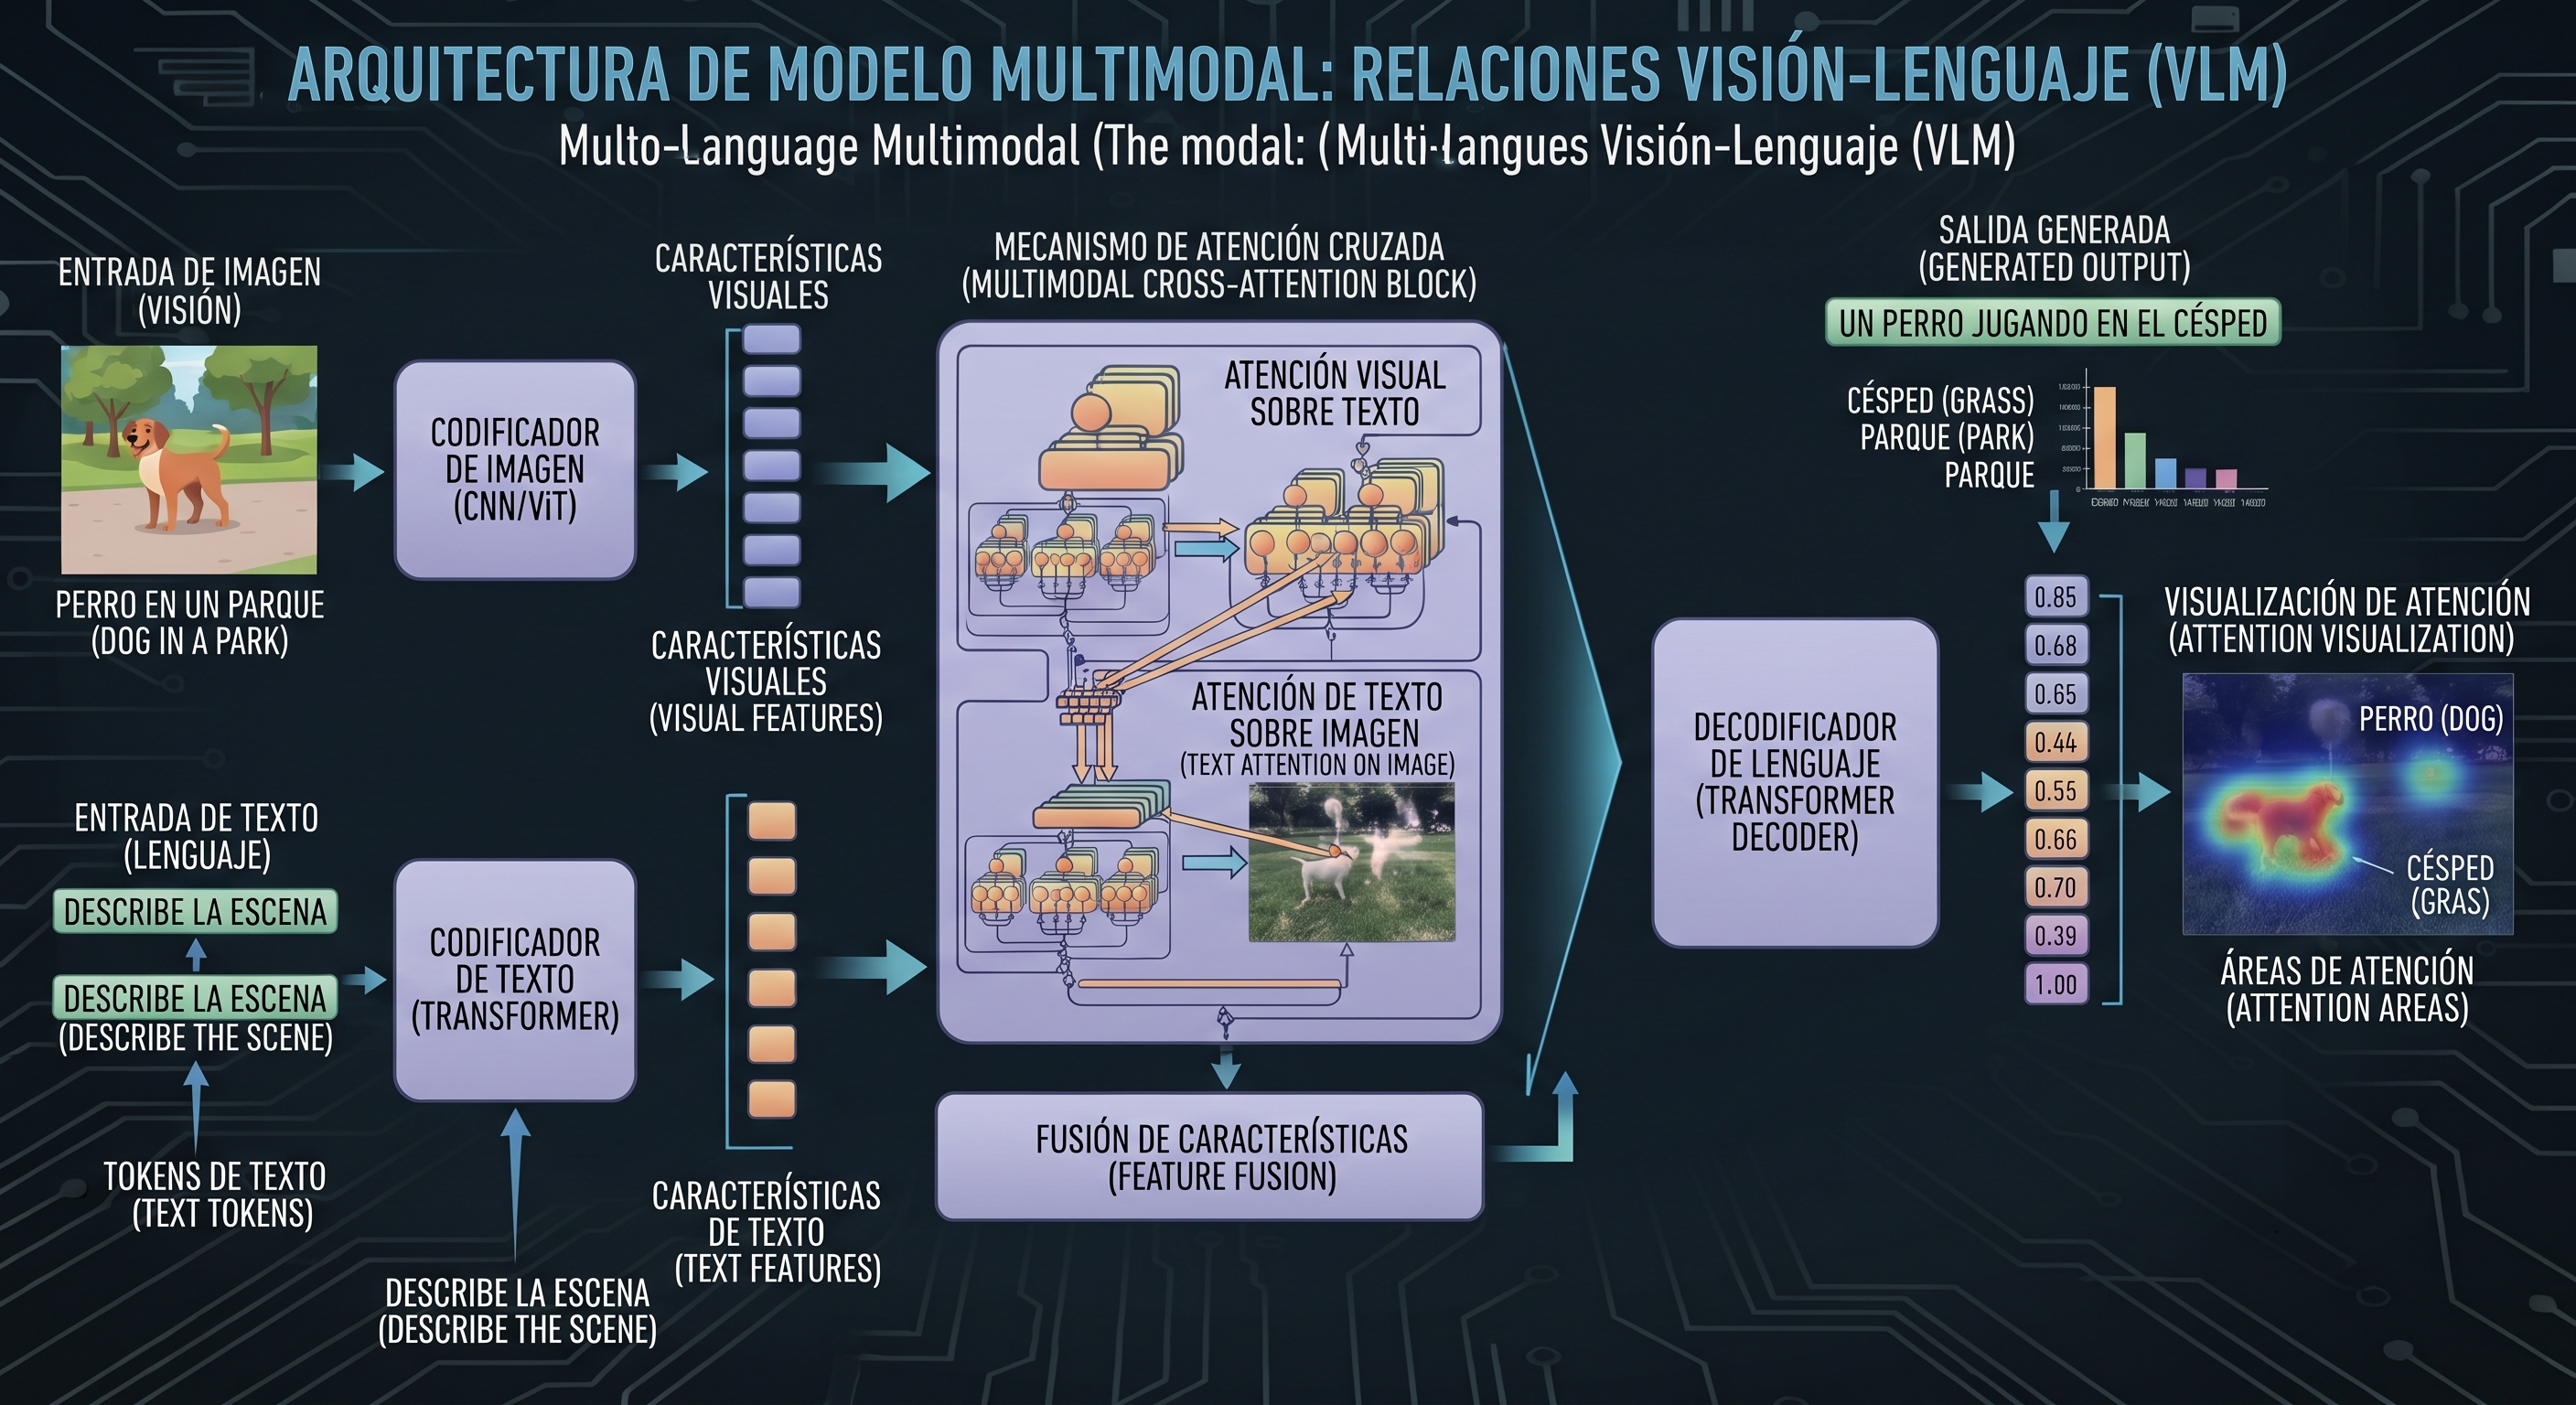
Entre las aplicaciones se encuentran la generación de descripciones automáticas, la recuperación de imágenes mediante consultas textuales, la respuesta a preguntas sobre contenido visual y la localización de elementos descritos verbalmente.
Estos sistemas aprenden representaciones compartidas o mecanismos de interacción entre modalidades. En ciertos diseños, el entrenamiento contrastivo acerca las representaciones de imágenes y textos relacionados y separa las correspondientes a contenidos diferentes.
Una revisión publicada en 2026 examinó 115 trabajos sobre modelos visión-lenguaje publicados entre 2018 y 2025. Los autores analizan preentrenamiento, ajuste fino, adaptación eficiente y evaluación, posteriormente destacan retos relacionados con escalabilidad, diversidad de datos, sesgos y generalización (Danish et al., 2026).
La integración multimodal amplía el alcance del análisis, aunque no garantiza que el modelo interprete correctamente todos los elementos visuales. Una descripción coherente en términos lingüísticos no demuestra, por sí sola, que el sistema haya identificado correctamente los objetos o sus relaciones.
Esta convergencia también permite comprender mejor el artículo Inteligencia Artificial, Big Data y Data Science: cómo se relacionan: los sistemas multimodales necesitan modelos de IA, datos adecuadamente preparados y metodología que permita evaluar la fiabilidad de sus resultados.
Evaluación (precisión, generalización y errores)
La evaluación de estos modelos exige métricas adaptadas a cada tarea. En clasificación de imágenes se utilizan precisión, recall, F1 y métricas específicas de segmentación. Y en generación textual interesan la adecuación semántica, la factualidad, la coherencia y la utilidad para la tarea.
En los modelos multimodales, por otra parte, es necesario comprobar si la respuesta se fundamenta realmente en la imagen proporcionada o si procede de asociaciones aprendidas durante el entrenamiento.
Un trabajo publicado en Findings of ACL 2025 estudia el fenómeno conocido como modality collapse, donde determinados modelos visión-lenguaje dependen excesivamente de la información textual y aprovechan insuficientemente las señales visuales. El hallazgo cuestiona la idea de que una puntuación elevada en un benchmark demuestre una comprensión multimodal robusta (Sim et al., 2025).
Este problema se aborda en el artículo Principales algoritmos de Machine Learning y para qué sirven: la selección de un modelo exige comparar alternativas bajo condiciones controladas y utilizar métricas coherentes con el objetivo. En Deep Learning, la validación debe contemplar también cambios de distribución, diferencias entre fuentes y posibles fugas de información entre entrenamiento y prueba.
Costes, datos y responsabilidad
Los modelos profundos suelen exigir importantes recursos de memoria, procesamiento y energía, especialmente durante el entrenamiento. Por ello, la elección arquitectónica debe valorar el coste de desarrollo y operación, la latencia necesaria y los recursos disponibles.
También es esencial examinar la procedencia de los datos, los derechos de uso, la representación de diferentes grupos y los riesgos derivados de errores sistemáticos. En sanidad, industria o servicios esenciales, un modelo debe evaluarse dentro de su contexto de utilización y no únicamente por su rendimiento agregado.
Para quienes cursan el Máster en Big Data y Data Science de la UNED, estos desafíos ofrecen una vía para conectar las técnicas de Deep Learning con problemas aplicados. Un proyecto académico bien delimitado podría comparar arquitecturas para una tarea concreta, analizar sus errores y estudiar cómo influyen la calidad de los datos y el coste computacional en los resultados. El objetivo no sería demostrar que el modelo más complejo es superior, sino justificar qué solución resulta más adecuada para las condiciones reales del problema.
Conclusiones
El Deep Learning ha ampliado las posibilidades del análisis de imágenes y lenguaje mediante arquitecturas capaces de aprender representaciones complejas. Las CNN y los Vision Transformers destacan en visión artificial. Los Transformers sustentan buena parte del procesamiento lingüístico contemporáneo. Y los modelos visión-lenguaje integran ambas modalidades para tareas como la búsqueda multimodal, la descripción de imágenes y la respuesta a preguntas visuales.
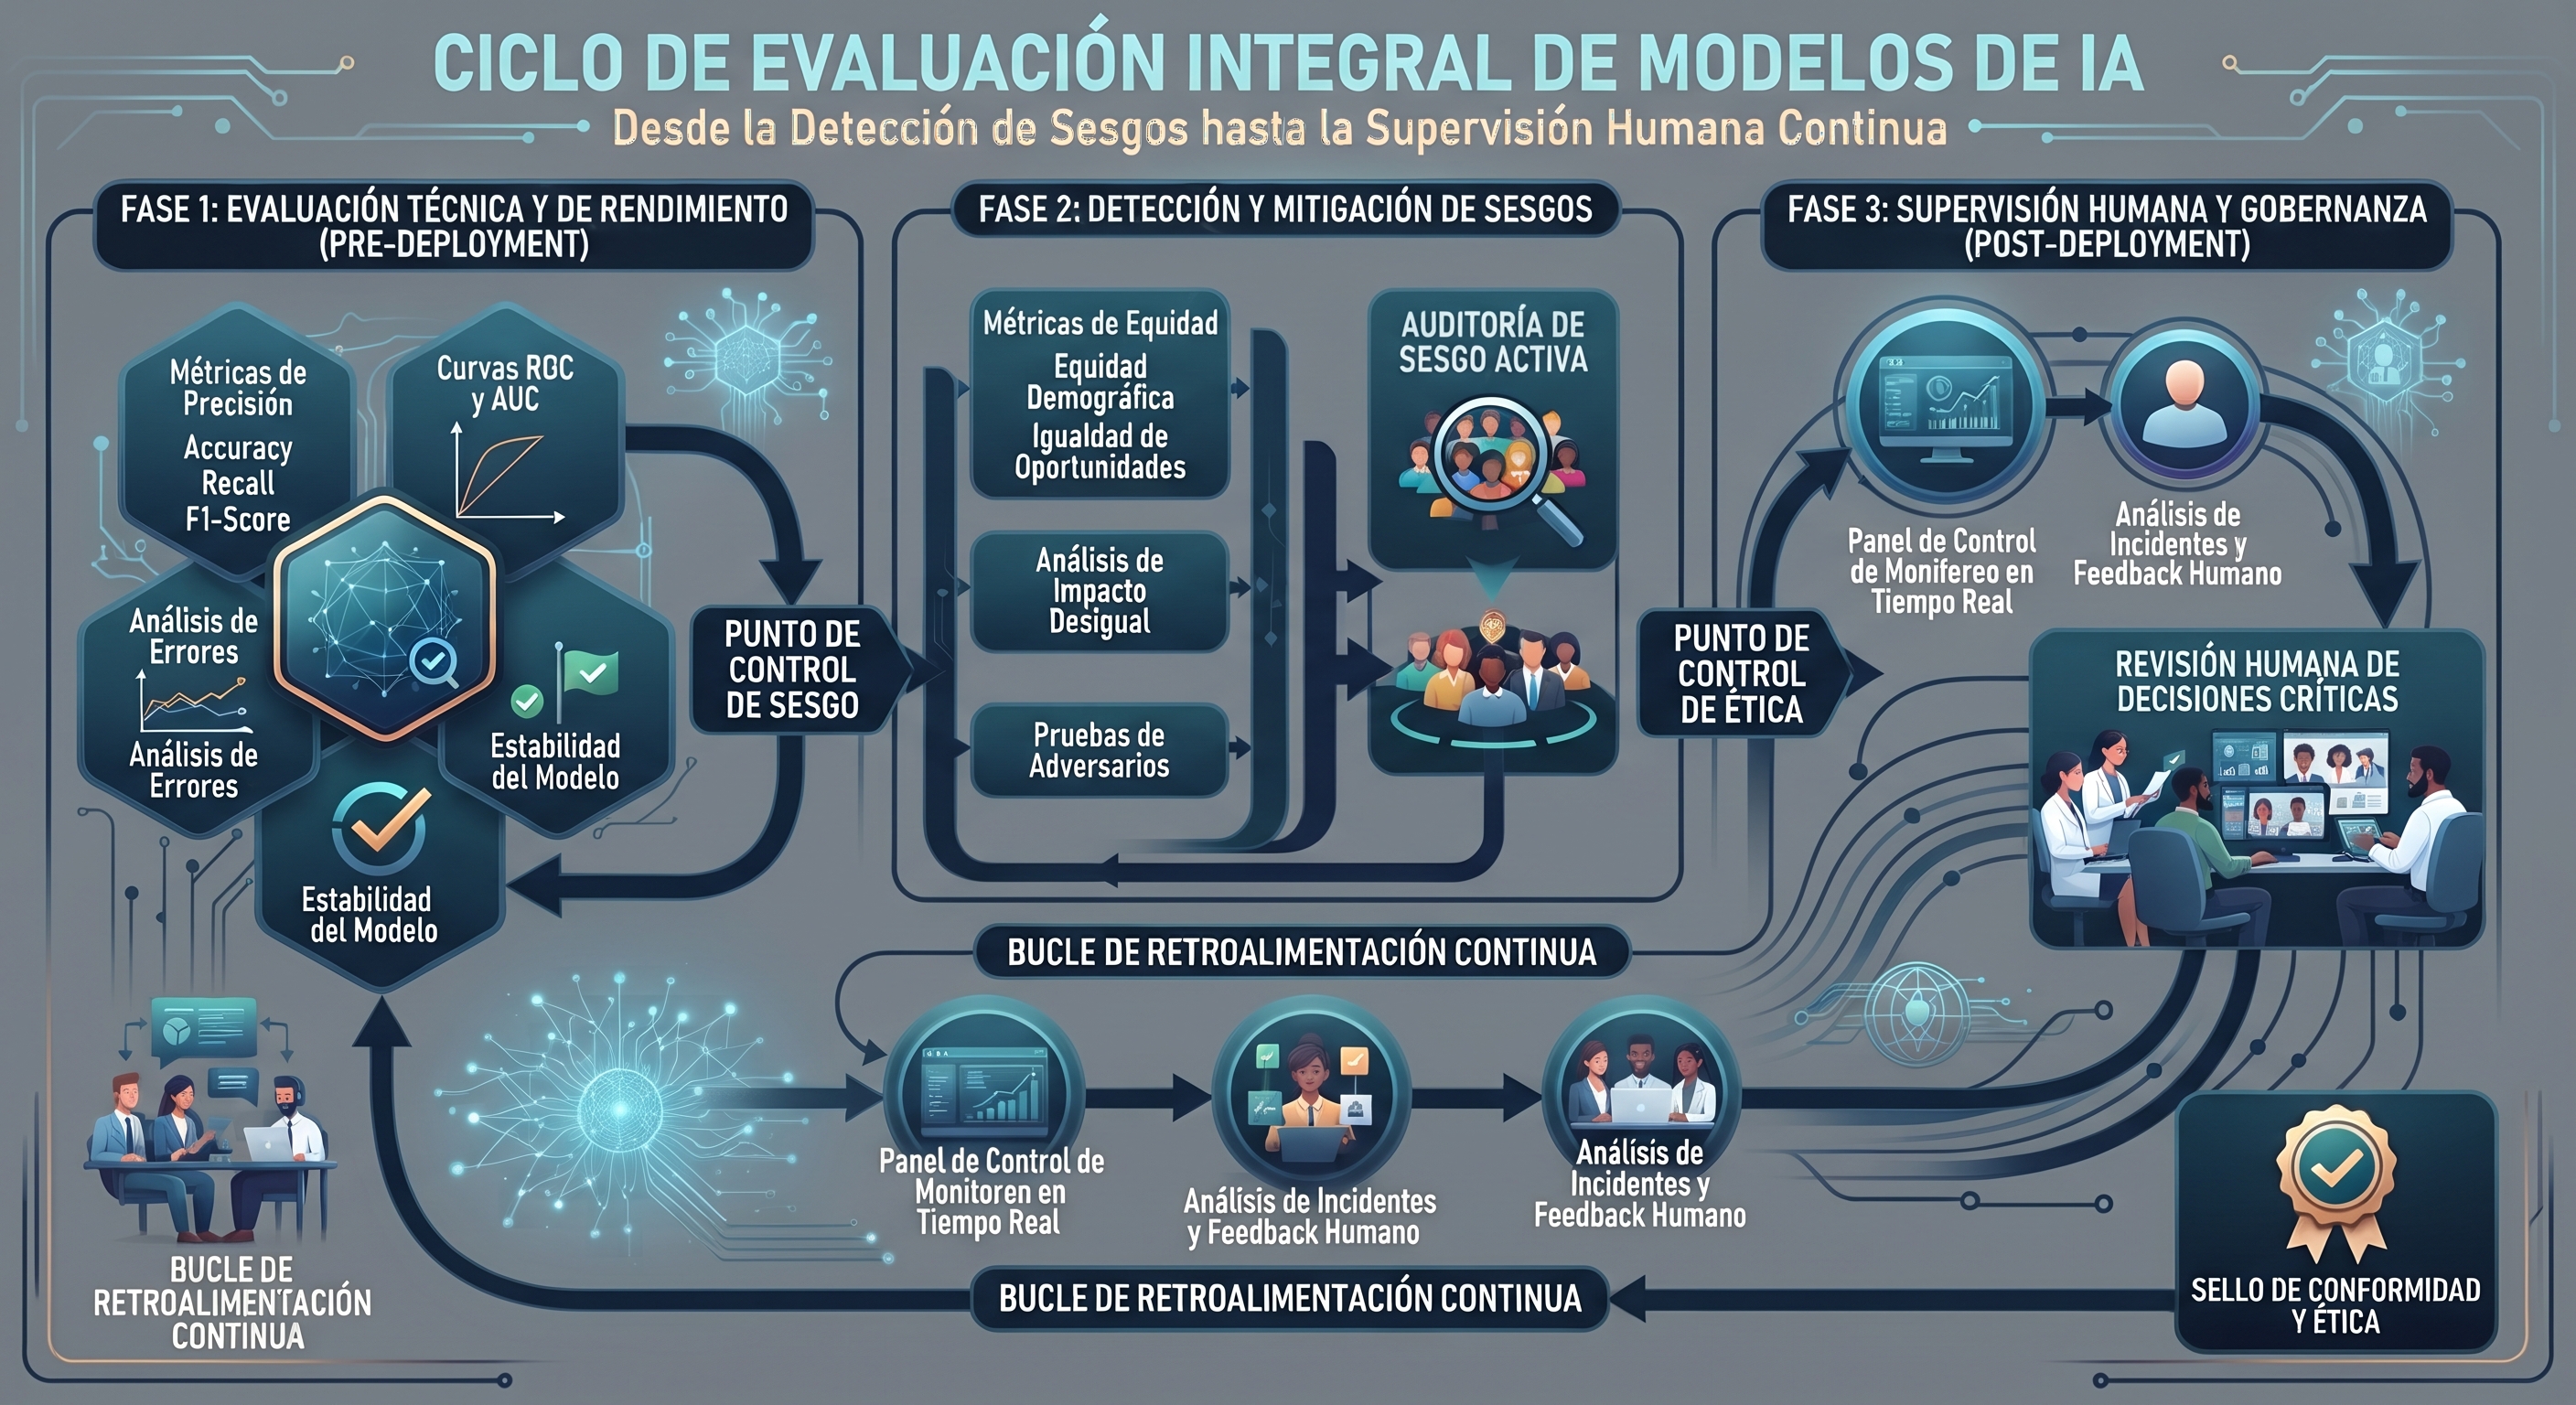
Sin embargo, la capacidad técnica debe acompañarse de evaluación rigurosa. La calidad de los datos, la generalización, sesgos, costes computacionales y fundamentación de las respuestas determinan la utilidad real de estas soluciones.
La competencia profesional pasa por seleccionar modelos adecuados, evaluar sus límites y demostrar utilidad en un problema concreto. Esta perspectiva víncula investigación, ingeniería y aplicación empresarial, a la vez que explica la importancia de estudiar el Deep Learning dentro de una formación integrada en Data Science.
FAQ sobre Deep Learning aplicado a imágenes y lenguaje
¿Qué aplicaciones tiene el Deep Learning en imágenes?
Clasificación, detección de objetos, segmentación, inspección industrial, análisis de imágenes médicas y reconocimiento de escenas.
¿Cómo se utiliza en el procesamiento del lenguaje natural?
Se emplea para clasificación textual, traducción, análisis de sentimiento, extracción de información, resumen, búsqueda semántica y generación de texto.
¿Qué diferencia existe entre una CNN y un Transformer?
Las CNN utilizan filtros para aprender patrones espaciales locales; los Transformers emplean mecanismos de atención para modelar relaciones entre elementos de una secuencia o representación.
¿Qué son los modelos visión-lenguaje?
Son sistemas entrenados para relacionar información visual y textual, con aplicaciones como descripción de imágenes, recuperación multimodal y respuesta a preguntas sobre contenido visual.
¿Qué conocimientos se necesitan para trabajar con estas tecnologías?
Programación, fundamentos de redes neuronales, preparación de datos, evaluación de modelos y comprensión de los problemas específicos de visión artificial y procesamiento del lenguaje.
¿Qué relación tiene el Máster de la UNED con este campo?
Su contenido incluye Deep Learning, CNN, redes recurrentes, Transformers y técnicas de minería de textos, proporcionando una base para estudiar aplicaciones de IA sobre información visual y lingüística.
Referencias bibliográficas
Danish, S., Sadeghi-Niaraki, A., Khan, S. U., Dang, L. M., Tightiz, L., & Moon, H. (2026). A comprehensive survey of Vision–Language Models: Pretrained models, fine-tuning, prompt engineering, adapters, and benchmark datasets. Information Fusion, 126(B), Article 103623. https://doi.org/10.1016/j.inffus.2025.103623
Laçi, H., Sevrani, K., & Iqbal, S. (2025). Deep learning approaches for classification tasks in medical X-ray, MRI, and ultrasound images: A scoping review. BMC Medical Imaging, 25, Article 156. https://doi.org/10.1186/s12880-025-01701-5
Qin, L., Chen, Q., Feng, X., Wu, Y., Zhang, Y., Li, Y., Li, M., Che, W., et al. (2026). Large language models meet NLP: A survey. Frontiers of Computer Science, 20, Article 2011361. https://doi.org/10.1007/s11704-025-50472-3
Sim, M. Y., Zhang, W. E., Dai, X., & Fang, B. (2025). Can VLMs actually see and read? A survey on modality collapse in vision-language models. In Findings of the Association for Computational Linguistics: ACL 2025 (pp. 24452–24470). Association for Computational Linguistics. https://doi.org/10.18653/v1/2025.findings-acl.1256
Tian, C., Cheng, T., Peng, Z., Zuo, W., Tian, Y., Zhang, Q., Wang, F.-Y., & Zhang, D. (2025). A survey on deep learning fundamentals. Artificial Intelligence Review, 58, Article 381. https://doi.org/10.1007/s10462-025-11368-7
Universidad Nacional de Educación a Distancia. (2026). Máster en Big Data y Data Science: contenido del programa. https://www.masterbigdataonline.com/contenido.html