Introducción
Guía Data Science - Deep Learning: Las redes neuronales artificiales constituyen uno de los modelos fundamentales de la inteligencia artificial contemporánea y una pieza central en el desarrollo Deep Learning. Su capacidad para aprender relaciones no lineales a partir de grandes conjuntos de datos ha permitido avances significativos en reconocimiento de imágenes, procesamiento del lenguaje natural, análisis de series temporales, sistemas de recomendación, detección de anomalías y numerosas aplicaciones científicas y empresariales.
Una red neuronal puede entenderse como modelo matemático formado por unidades interconectadas que transforman progresivamente X datos de entrada hasta producir una salida. La arquitectura incorpora parámetros (principalmente pesos y sesgos) que son ajustados durante el entrenamiento para reducir el error de las predicciones. Las capas ocultas y las funciones de activación permiten representar relaciones no lineales que resultarían difíciles de capturar mediante modelos lineales convencionales. (ibm.com)
El desarrollo reciente del Deep Learning ha ampliado considerablemente estas capacidades. Las investigaciones publicadas en 2025 destacan la evolución de redes profundas y arquitecturas como las redes convolucionales, recurrentes, GAN y Transformers, aplicadas a dominios tan diversos como visión artificial, lenguaje, salud o predicción. (link.springer.com)
Comprender qué es una red neuronal y cómo aprende resulta, por lo tanto, esencial para interpretar esa parte tan considerable de los sistemas actuales de inteligencia artificial.
¿Qué es una red neuronal artificial?
Una red neuronal artificial es un modelo computacional que aprende la “función” a partir de ejemplos, la estructura básica está formada por una capa de entrada, una o varias capas ocultas y otra capa de salida.
La capa de entrada recibe las características que describen cada observación. Las capas ocultas transforman progresivamente dichas características mediante operaciones matemáticas y funciones no lineales. Finalmente, la capa de salida genera la predicción correspondiente al problema planteado. (ibm.com)
Cada conexión contiene un peso que determina la influencia de una entrada sobre el cálculo posterior. A esto se añade normalmente un término de sesgo. En la neurona simplificada, el cálculo puede representarse como:
z = w₁x₁ + w₂x₂ + … + wₙxₙ + b
Y posteriormente:
a = σ(z)
Donde x representa las entradas, w los pesos, b el sesgo y σ la función de activación. Diremos que la red aprende modificando los parámetros para que la salida se aproxime progresivamente a los valores deseados.
¿Cómo funcionan las capas de una red neuronal?
Capa de entrada
La capa de entrada no “aprende” en el mismo sentido que las capas internas, recibe representación numérica de los datos. En un problema financiero, por ejemplo, podría contener variables como ingresos, edad, historial de pagos o endeudamiento. En una imagen, las entradas pueden representar valores de píxeles o características derivadas. En procesamiento del lenguaje, las entradas se representan mediante estructuras numéricas como tokens y embeddings.
La calidad de esta representación resulta determinante. Aunque las redes profundas reducen la necesidad de diseñar manualmente muchas características, siguen dependiendo de datos adecuados, representativos y correctamente preparados.
Capas ocultas
En las capas ocultas es donde se produce buena parte de la transformación que experimenta la información. Una primera capa aprende combinaciones simples de las variables de entrada, las siguientes construyen representaciones progresivamente más complejas. En visión artificial, para seguir con otro ejemplo, una red profunda aprende representaciones jerárquicas que evolucionan desde características elementales en dirección a patrones de mayor nivel.
Aquí tenemos un principio muy importante: la red profunda no es igual a añadir neuronas. La potencia aparece en la composición de múltiples transformaciones que permiten aproximar relaciones complejas en los datos.
Capa de salida
La capa final adapta su salida al objetivo del modelo. En clasificación binaria utiliza la salida asociada a una probabilidad, en clasificación multiclase suele emplearse una función softmax y en regresión puede producir directamente un valor numérico. El diseño de esta capa depende, por lo tanto, del tipo de tarea.
La función de activación es necesaria
Cierta cuestión aparentemente sencilla explica buena parte de la capacidad de las redes neuronales: hablamos de funciones de activación.
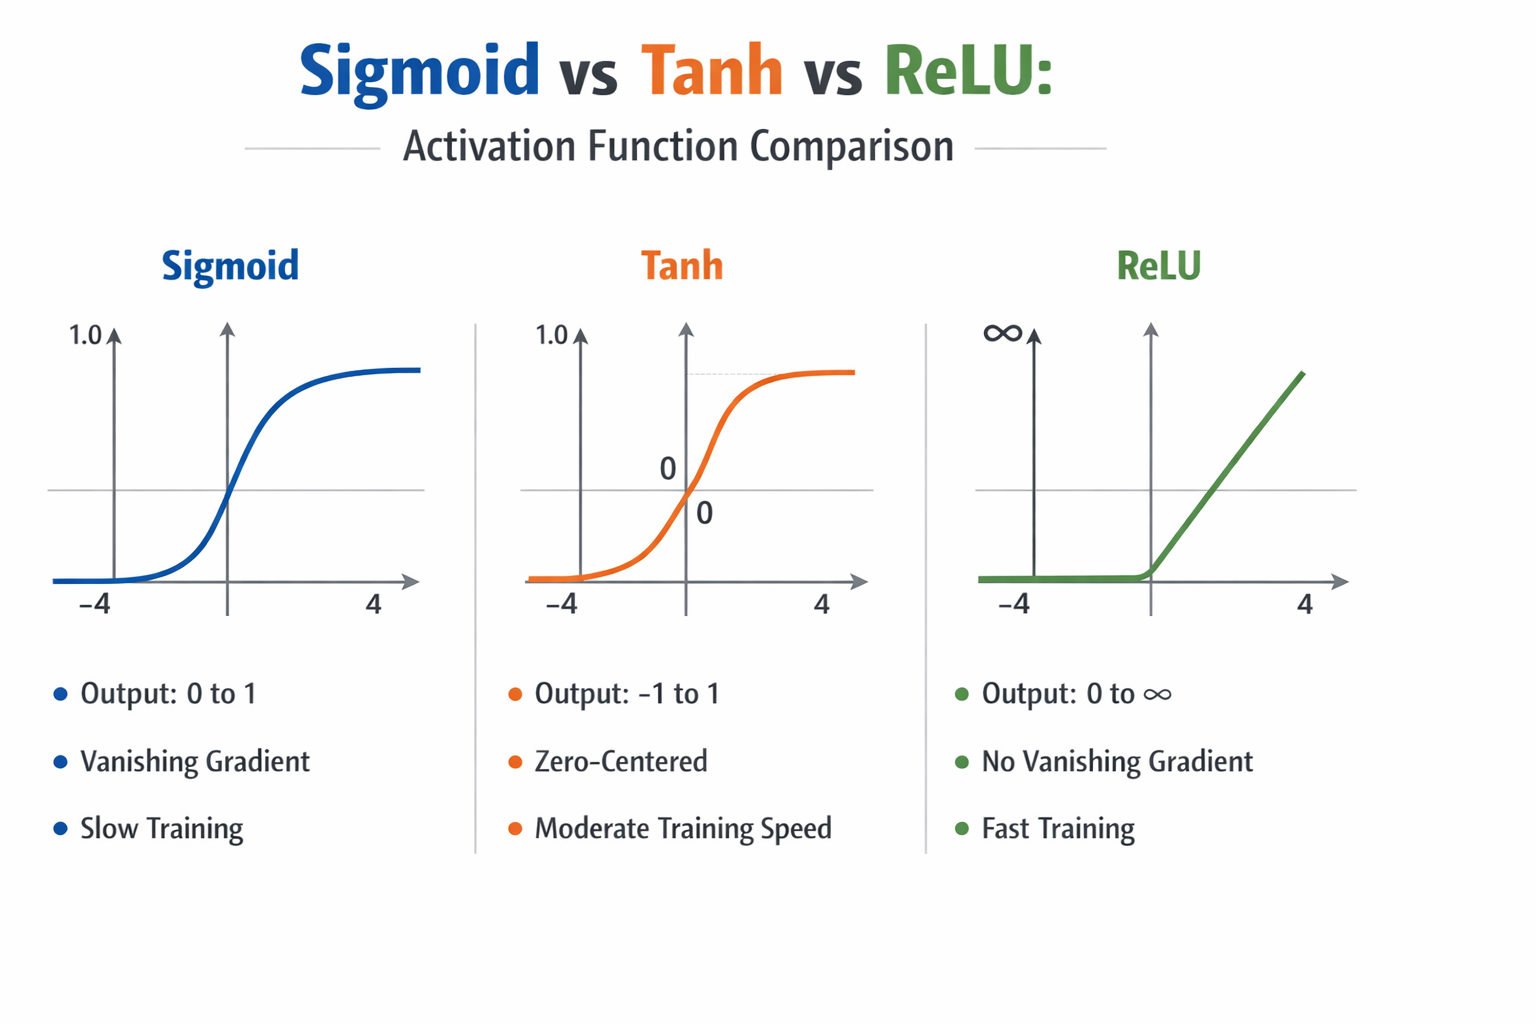
Si todas las capas realizaran exclusivamente transformaciones lineales, la composición de varias capas seguiría siendo lineal. Añadir profundidad no permitiría representar relaciones verdaderamente más complejas. Pero las funciones de activación introducen la no linealidad necesaria. (developers.google.com)
Entre las funciones más conocidas se encuentran sigmoid, tanh y ReLU. ReLU —Rectified Linear Unit— es especialmente utilizada porque facilita el entrenamiento de redes profundas en numerosos escenarios. Google señala, por otra parte, que su utilización puede ayudar a reducir algunos problemas asociados a la desaparición de gradientes. (developers.google.com)
La elección de la activación depende de la arquitectura y del tipo de problema, sin embargo, no existe una función universalmente óptima para todas las situaciones.
¿Cómo aprende una red neuronal?
Aquí vemos algo fascinante: el entrenamiento consiste, esencialmente, en un ciclo de predicción, cálculo del error y actualización de parámetros.
En primer lugar, la red recibe datos y genera una predicción. En segundo lugar, se calcula una función de pérdida que cuantifica la discrepancia entre esa predicción y el resultado esperado. Y, en tercer lugar, los parámetros se actualizan para reducir la pérdida. Este proceso se repite numerosas veces, utilizando diferentes lotes de datos hasta que el modelo alcanza algún nivel de rendimiento considerado suficiente.
Propagación hacia delante
En lo que denominamos propagación hacia delante o forward propagation, la información circula desde entrada hasta salida. Cada capa recibe la representación producida por la anterior y realiza una transformación. El resultado final constituye la predicción del modelo.
Podríamos simplificar el proceso como:
Datos → capa de entrada → capas ocultas → capa de salida → predicción
Claro, la red todavía no “sabe” si su predicción es buena (para eso es necesario calcular la pérdida).
Función de pérdida
La loss function transforma el error entre predicción y objetivo en una cantidad que el algoritmo puede utilizar para optimizar los parámetros. En clasificación se emplean frecuentemente funciones basadas en entropía cruzada. En regresión, uno de los enfoques clásicos utiliza el error cuadrático medio. La documentación actual de scikit-learn muestra, por ejemplo, cómo las implementaciones de MLP minimizan funciones de pérdida mediante métodos de optimización y retropropagación. (scikit-learn.org)
Retropropagación y descenso de gradiente
Después de calcular la pérdida entra en funcionamiento la retropropagación (backpropagation). El algoritmo calcula cómo cambia la pérdida cuando se modifica cada parámetro y transmite esa información hacia las capas anteriores. A partir de esos gradientes, un optimizador actualiza los pesos en una dirección que, en términos más o menos generales, pretende reducir el error. Google identifica la propagación inversa como el algoritmo de entrenamiento más habitual para redes neuronales multicapa. (developers.google.com)
La regla conceptual del descenso de gradiente puede expresarse como:
Wₙ₊₁ = Wₙ − η∇L(Wₙ)
Donde W representa los parámetros, η la tasa de aprendizaje y ∇L el gradiente de la función de pérdida.
El mecanismo parece sencillo en abstracto, pero en redes modernas puede implicar millones o incluso miles de millones de parámetros. De ahí la importancia de la capacidad computacional y de técnicas avanzadas de optimización.
¿Qué es una red neuronal profunda?
Ahora bien, una red neuronal con múltiples capas ocultas se considera una red neuronal profunda o Deep Neural Network. Así, el Deep Learning constituye una rama del Machine Learning que utiliza redes con múltiples capas para aprender representaciones progresivamente más complejas.
Las indagaciones más recientes destacan precisamente esta capacidad de aprender representaciones jerárquicas, reduciendo en algunas situaciones la necesidad de diseñar manualmente características a partir de los datos brutos. (sciencedirect.com)
La profundidad, sin embargo, también aumenta la complejidad del entrenamiento. Pueden aparecer problemas como gradientes que se desvanecen o explotan, sobreajuste y elevados costes computacionales. Google señala, entre las estrategias de entrenamiento, la utilización de ReLU, normalización por lotes, ajuste de la tasa de aprendizaje y dropout, como mecanismos que pueden ayudar a afrontar ciertos problemas asociados. (developers.google.com)
Principales arquitecturas de redes neuronales
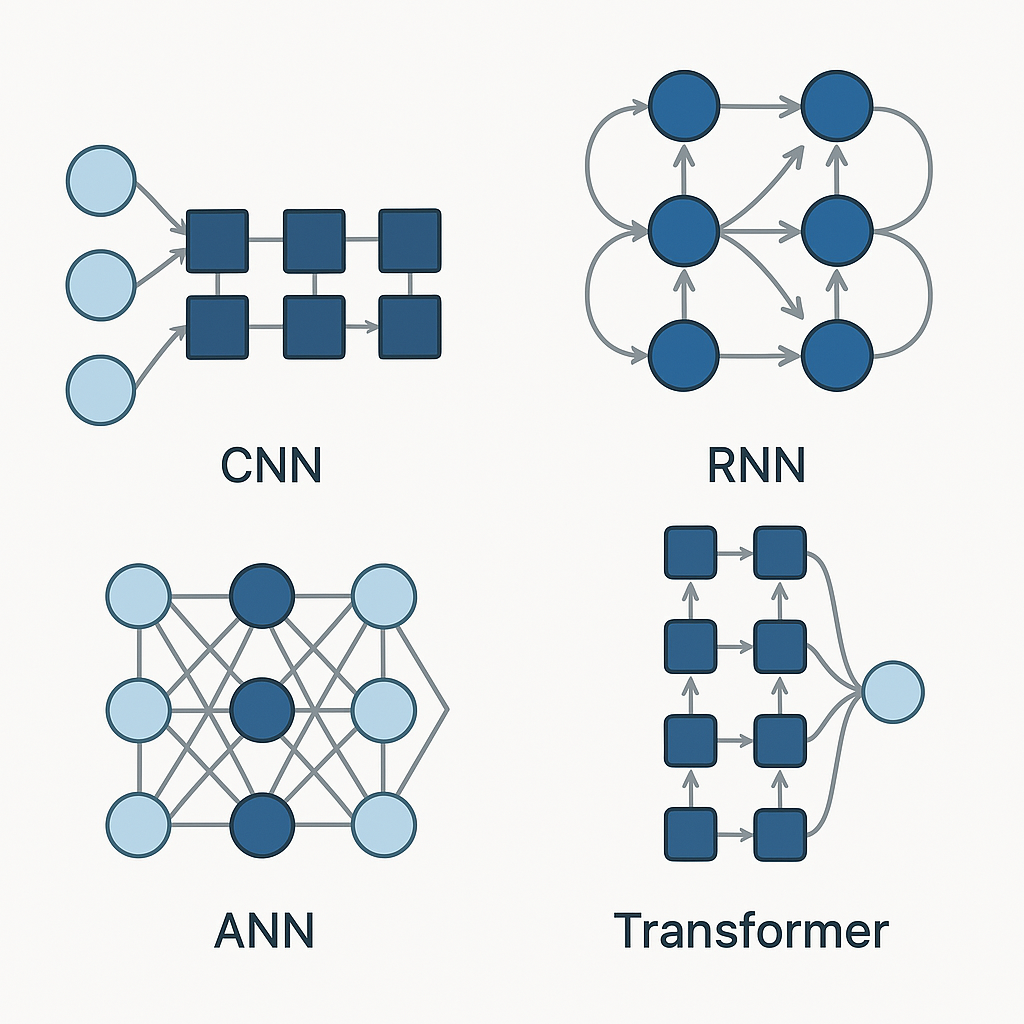
Naturalmente, no existe una única arquitectura neuronal, cada familia responde a determinadas propiedades de los datos.
Redes neuronales feedforward y perceptrón multicapa
El perceptrón multicapa (MLP) es una arquitectura clásica donde la información avanza desde entrada hacia salida sin conexiones recurrentes. Puede utilizarse tanto para clasificación como para regresión y aprender relaciones no lineales. Scikit-learn implementa este modelo mediante MLPClassifier y MLPRegressor. (scikit-learn.org)
Redes convolucionales
Las redes neuronales convolucionales (CNN) fueron diseñadas para aprovechar la estructura espacial de algunos cúmulos de datos, especialmente imágenes. Utilizan filtros convolucionales que permiten detectar patrones locales y construir representaciones jerárquicas.
Éstas han tenido un papel fundamental en visión artificial y análisis de imágenes, aunque las arquitecturas contemporáneas han ampliado considerablemente el repertorio de técnicas utilizadas en este campo. Las revisiones publicadas en 2025 incluyen las CNN entre las principales familias del Deep Learning. (sciencedirect.com)
Redes recurrentes
Las RNN fueron concebidas para trabajar con datos secuenciales, manteniendo información relacionada con estados anteriores, se han utilizado en series temporales y procesamiento del lenguaje.
Aunque continúan siendo relevantes conceptualmente, los avances posteriores han dado mayor protagonismo a otras arquitecturas para algunas tareas secuenciales. Las revisiones actuales sobre Deep Learning siguen situando RNN, CNN y Transformers dentro de la evolución histórica de las arquitecturas neuronales. (sciencedirect.com)
Transformers
Los Transformers han transformado el procesamiento del lenguaje natural y posteriormente se han extendido a otras modalidades y problemas. Su mecanismo de atención permite modelar relaciones entre diferentes posiciones de una secuencia y ha contribuido al desarrollo de los actuales modelos de lenguaje de gran escala.
Google incorpora actualmente el estudio de Transformers y grandes modelos de lenguaje dentro del itinerario avanzado de Machine Learning, señalando la importancia en la evolución de los sistemas generativos contemporáneos. (developers.google.com)
¿Para qué se utilizan las redes neuronales?
Bien, las aplicaciones de las redes neuronales son extraordinariamente amplias. En visión artificial, permiten tareas como clasificación de imágenes, detección de objetos y segmentación. En lenguaje natural, intervienen en traducción automática, clasificación de documentos, asistentes conversacionales y modelos generativos.
En el ámbito empresarial se utilizan para previsión de demanda, recomendación de productos, detección de fraude, mantenimiento predictivo y análisis de comportamiento. En ciencia y salud se aplican a problemas de imagen médica, predicción de series temporales y análisis de datos complejos.
Las revisiones científicas recientes también subrayan precisamente la expansión hacia salud, visión, lenguaje y otros dominios, así como los retos asociados a la complejidad y dinámica de los problemas reales. (sciencedirect.com)
Redes neuronales y análisis de datos
La utilidad de una red neuronal no puede separarse de la calidad y estructura de los datos utilizados para entrenarla. Cualquier modelo avanzado necesita datasets adecuados, procesos de limpieza y transformación, selección o construcción de variables, división entre entrenamiento y evaluación más métricas coherentes con el objetivo. El desarrollo de un modelo neuronal es, por lo tanto, parte de un pipeline de Data Science mucho más amplio.
Este punto conecta directamente con la formación especializada en datos. El Máster en Big Data y Data Science de la UNED (con sus 60 ECTS) integra los contenidos relacionados con Data Science y Big Data más avanzados (herramientas Big Data, análisis multivariante y minería de datos) y necesarios para avanzar en estos revolucionarios paradigmas tecnológicos.
La relación entre ambas disciplinas (Data Science y Big Data) es especialmente importante, las redes neuronales necesitan una infraestructura capaz de gestionar datos a escala, además de conocimientos estadísticos y computacionales para construir y evaluar los modelos.
Ventajas y limitaciones de las redes neuronales
Su principal ventaja reside en la capacidad de modelar relaciones complejas y no lineales y, en arquitecturas profundas, aprender representaciones a partir de los propios datos.
Por supuesto, un modelo más complejo no es automáticamente un modelo mejor. Las redes neuronales requieren grandes cantidades de datos, recursos computacionales significativos y procesos de ajuste cuidadosos. También pueden sobreajustar los datos de entrenamiento y presentar dificultades de interpretación.
La generalización constituye una cuestión especialmente relevante. Una red no debe limitarse a memorizar patrones del conjunto utilizado para entrenarla, necesita mantener un rendimiento adecuado ante datos nuevos. La revisión publicada en Neurocomputing en 2025 destaca, precisamente, la generalización como un problema que debe analizarse en distintos niveles, por ejemplo, partiendo de nuevas muestras y llegando a cambios de distribución, dominio y tarea. (sciencedirect.com)
De lo anterior extraemos que la evaluación externa y la validación son componentes esenciales del desarrollo de cualquier modelo neuronal.
Redes neuronales en proyectos profesionales de Data Science
En un proyecto real, la pregunta facialmente podría ser qué red neuronal utilizar. Sin embargo, formulemos un interrogante anterior: ¿Es una red neuronal la mejor solución para el problema?
Claramente, existen situaciones en las que modelos más sencillos ofrecen resultados comparables con menor coste y mayor interpretabilidad. Una red neuronal adquiere especial interés cuando la complejidad de los patrones, volumen de datos o la naturaleza de la información justifican su utilización.
Esta es perspectiva que resulta fundamental para el científico o científica de datos. El profesional al que aspira el mercado actual debe saber seleccionar el modelo apropiado, diseñar experimentos, establecer métricas, evitar fugas de información, controlar el sobreajuste y documentar las decisiones metodológicas.
En sentido de lo anterior, el Máster en Big Data y Data Science de la UNED debe entenderse desde cierta perspectiva más amplia que el aprendizaje de herramientas aisladas. El programa modular de la UNED (Experto, Especialista y Máster) combina análisis de datos, minería, herramientas Big Data y fundamentos de Data Science, competencias que permiten contextualizar modelos avanzados dentro del ciclo completo de tratamiento de la información.
A modo de conclusiones
Las redes neuronales artificiales son modelos matemáticos capaces de aprender relaciones complejas mediante la combinación de capas de unidades, pesos, sesgos y funciones de activación. El entrenamiento se basa en una secuencia de propagación hacia delante, cálculo de la pérdida y actualización de parámetros mediante retropropagación y métodos de optimización.
La aparición de arquitecturas profundas viene ampliado sus posibilidades, permitiendo desarrollar sistemas de enorme capacidad en ámbitos como visión artificial, lenguaje natural, predicción y generación de contenidos. Las CNN, RNN y Transformers representan diferentes etapas y estrategias dentro de esta evolución.
Sin embargo, la capacidad de una red neuronal no depende únicamente de la arquitectura. Los datos, el diseño experimental, la función de pérdida, la optimización, la capacidad computacional y la evaluación determinan en gran medida el rendimiento final.
Para un profesional de Data Science, comprender estas relaciones es más importante que memorizar el funcionamiento de una arquitectura concreta. La red neuronal es una herramienta dentro de un proceso mayor, que podemos caracterizar como: definir el problema, preparar los datos, construir el modelo, evaluar su generalización e interpretar sus resultados.
En este escenario nuestro de crecimiento continuo de datos y expansión de la inteligencia artificial, la visión integral permite comprender por qué las redes neuronales se han convertido en una tecnología central y, al mismo tiempo, por qué su utilización responsable requiere fundamentos sólidos en estadística, programación, análisis de datos y arquitectura Big Data.
FAQ: sobre redes neuronales artificiales
¿Qué es una red neuronal artificial?
Es un modelo computacional formado por unidades conectadas mediante parámetros que aprende una función a partir de datos. Está compuesto normalmente por una capa de entrada, capas ocultas y una capa de salida.
¿Cómo aprende una red neuronal?
Aprende ajustando pesos y sesgos para minimizar una función de pérdida. El proceso utiliza habitualmente propagación hacia delante, retropropagación y un algoritmo de optimización basado en gradientes. (developers.google.com)
¿Qué es una neurona artificial?
Es una unidad matemática que combina entradas mediante pesos y un sesgo y aplica posteriormente una función de activación. La combinación de muchas unidades permite construir representaciones de mayor complejidad.
¿Qué diferencia existe entre Machine Learning y Deep Learning?
El Deep Learning es un subcampo del Machine Learning basado principalmente en redes neuronales con múltiples capas. La capacidad para aprender representaciones jerárquicas distingue las posibles utilizaciones frente a métodos tradicionales de aprendizaje automático.
¿Qué función tiene una función de activación?
Introduce no linealidad en la red. Sin esa no linealidad, la composición de múltiples capas lineales seguiría siendo una transformación lineal y la profundidad aportaría mucha menos capacidad de representación. (developers.google.com)
¿Qué es la retropropagación?
Es el procedimiento mediante el cual se calculan los gradientes de la función de pérdida respecto de los parámetros de la red, permitiendo actualizar los pesos durante el entrenamiento. (developers.google.com)
¿Para qué se utilizan las redes neuronales?
Se emplean en clasificación, regresión, visión artificial, procesamiento del lenguaje, predicción de series temporales, recomendación, detección de anomalías y numerosos sistemas de inteligencia artificial.
¿Las redes neuronales son siempre la mejor opción?
No. Su conveniencia depende del problema, los datos disponibles, el coste computacional, la necesidad de interpretabilidad y el rendimiento esperado. Un modelo más complejo no es necesariamente superior en todos los contextos.
¿Qué relación existe entre redes neuronales, Big Data y Data Science?
Las redes neuronales proporcionan modelos de aprendizaje, Data Science integra estos modelos con estadística, programación, preparación y evaluación de datos y Big Data aporta las arquitecturas y tecnologías necesarias cuando la escala de la información exige procesamiento distribuido y almacenamiento masivo.
Referencias bibliográficas
Goodfellow, I., Bengio, Y., & Courville, A. (2016). Deep learning. MIT Press. https://www.deeplearningbook.org/
IBM. (2023). ¿Qué es una red neuronal? IBM Think. https://www.ibm.com/es-es/think/topics/neural-networks
National Institute of Standards and Technology. (2023). Artificial intelligence risk management framework (AI RMF 1.0) (NIST AI 100-1). U.S. Department of Commerce. https://doi.org/10.6028/NIST.AI.100-1
scikit-learn developers. (2026). Neural network models (supervised). Scikit-learn documentation. https://scikit-learn.org/stable/modules/neural_networks_supervised.html
scikit-learn developers. (2026). Model evaluation: Quantifying the quality of predictions. Scikit-learn documentation. https://scikit-learn.org/stable/modules/model_evaluation.html
Tian, C., Cheng, T., Peng, Z., Zuo, W., Tian, Y., Zhang, Q., Wang, F.-Y., & Zhang, D. (2025). A survey on deep learning fundamentals. Artificial Intelligence Review, 58, 381. https://doi.org/10.1007/s10462-025-11368-7
Kim, J., Kim, H., Lee, D., & Yoon, S. (2025). A comprehensive survey of deep learning for time series forecasting: Architectural diversity and open challenges. Artificial Intelligence Review, 58, 216. https://doi.org/10.1007/s10462-025-11223-9
Google for Developers. (2025). Neural networks. Google Machine Learning Crash Course. https://developers.google.com/machine-learning/crash-course/neural-networks
Google for Developers. (2025). Neural networks: Activation functions. Google Machine Learning Crash Course. https://developers.google.com/machine-learning/crash-course/neural-networks/activation-functions
Google for Developers. (2025). Neural networks: Training using backpropagation. Google Machine Learning Crash Course. https://developers.google.com/machine-learning/crash-course/neural-networks/backpropagation
Hassanin, M., et al. (2025). A survey on state-of-the-art deep learning applications and challenges. Engineering Applications of Artificial Intelligence, 159, 111225. https://doi.org/10.1016/j.engappai.2025.111225
Universidad Nacional de Educación a Distancia. (2026). Big Data y Data Science aplicados a la Economía y a la Administración y Dirección de Empresas. Formación Permanente UNED. https://www.masterbigdataonline.com