Introducción
Guía Data Science - R para Data Science: La expansión de la inteligencia artificial y el aprendizaje automático ha situado a Python en una posición destacada dentro del ecosistema de la ciencia de datos. Sin embargo, reducir Data Science a la programación de algoritmos predictivos supondría ignorar una parte esencial de la disciplina que aquí nos reúne: el razonamiento estadístico que permite interpretar los datos, cuantificar la incertidumbre y evaluar la solidez de las conclusiones.
R mantiene una función relevante. Diseñado específicamente para la computación estadística y la representación gráfica, reúne herramientas para el análisis exploratorio, inferencia, modelización y comunicación de resultados. Su arquitectura extensible y comunidad de desarrollo han favorecido la incorporación de métodos especializados en campos como la economía, la epidemiología, las ciencias sociales y la investigación biomédica.
Claro, esta importancia actual de R no reside en que sea la mejor herramienta para cualquier proyecto, es más bien que responde con especial profundidad a problemas donde la estadística forma el núcleo del trabajo analítico. Comprender sus fortalezas, limitaciones y posibilidades de integración con otras tecnologías nos ayudará a tomar decisiones metodológicas mejor fundamentadas.
¿Qué es R y cuál es su función en estadística?
R es un lenguaje de programación y un entorno de software libre para la computación estadística y los gráficos. El proyecto oficial destaca la capacidad para desarrollar modelos lineales y no lineales, contrastes estadísticos, análisis de series temporales, clasificación y agrupamiento, además de ampliar sus funciones mediante paquetes especializados (R Core Team, s. f.).
Esta orientación distingue a R de las herramientas concebidas principalmente para administrar sistemas, desarrollar aplicaciones generales o construir infraestructuras de producción. Hablamos de un diseño que facilita expresar procedimientos estadísticos, transformar datos y representar resultados dentro de un mismo flujo de trabajo.
El ecosistema incluye recursos para manipular tablas, ajustar modelos, examinar distribuciones, estimar parámetros y construir visualizaciones. Por otra parte, la disponibilidad de paquetes especializados permite abordar problemas metodológicos avanzados sin tener que implementar cada algoritmo desde cero. No obstante, la existencia de una función informática no garantiza que la utilización resulte siempre adecuada, la elección del procedimiento exige comprender supuestos y el tipo de evidencia disponible.
Y tenemos una relación con el Máster en Big Data y Data Science de la UNED. El programa incluye R y Python en la formación inicial, junto con contenidos de estadística, preprocesamiento y herramientas de análisis. Esta combinación sitúa la programación en un contexto correcto, como instrumento para aplicar métodos cuantitativos, no como sustituto del conocimiento estadístico.
Por qué R sigue destacando en el análisis estadístico
Inferencia estadística y modelización
Una de las principales fortalezas de R es la amplitud de recursos para estudiar relaciones entre variables y valorar la incertidumbre. El lenguaje dispone de funciones y paquetes para regresión, análisis de varianza, contrastes de hipótesis, modelos generalizados, estimación, remuestreo y técnicas multivariantes.
Estas herramientas permiten examinar preguntas que van más allá de la predicción. En investigación sanitaria, por ejemplo, interesa estimar la asociación entre exposición y resultado clínico, controlar variables de confusión y comunicar intervalos de confianza. En economía, el análisis de una serie temporal exige estudiar tendencias, dependencia y estacionalidad antes de producir previsiones.
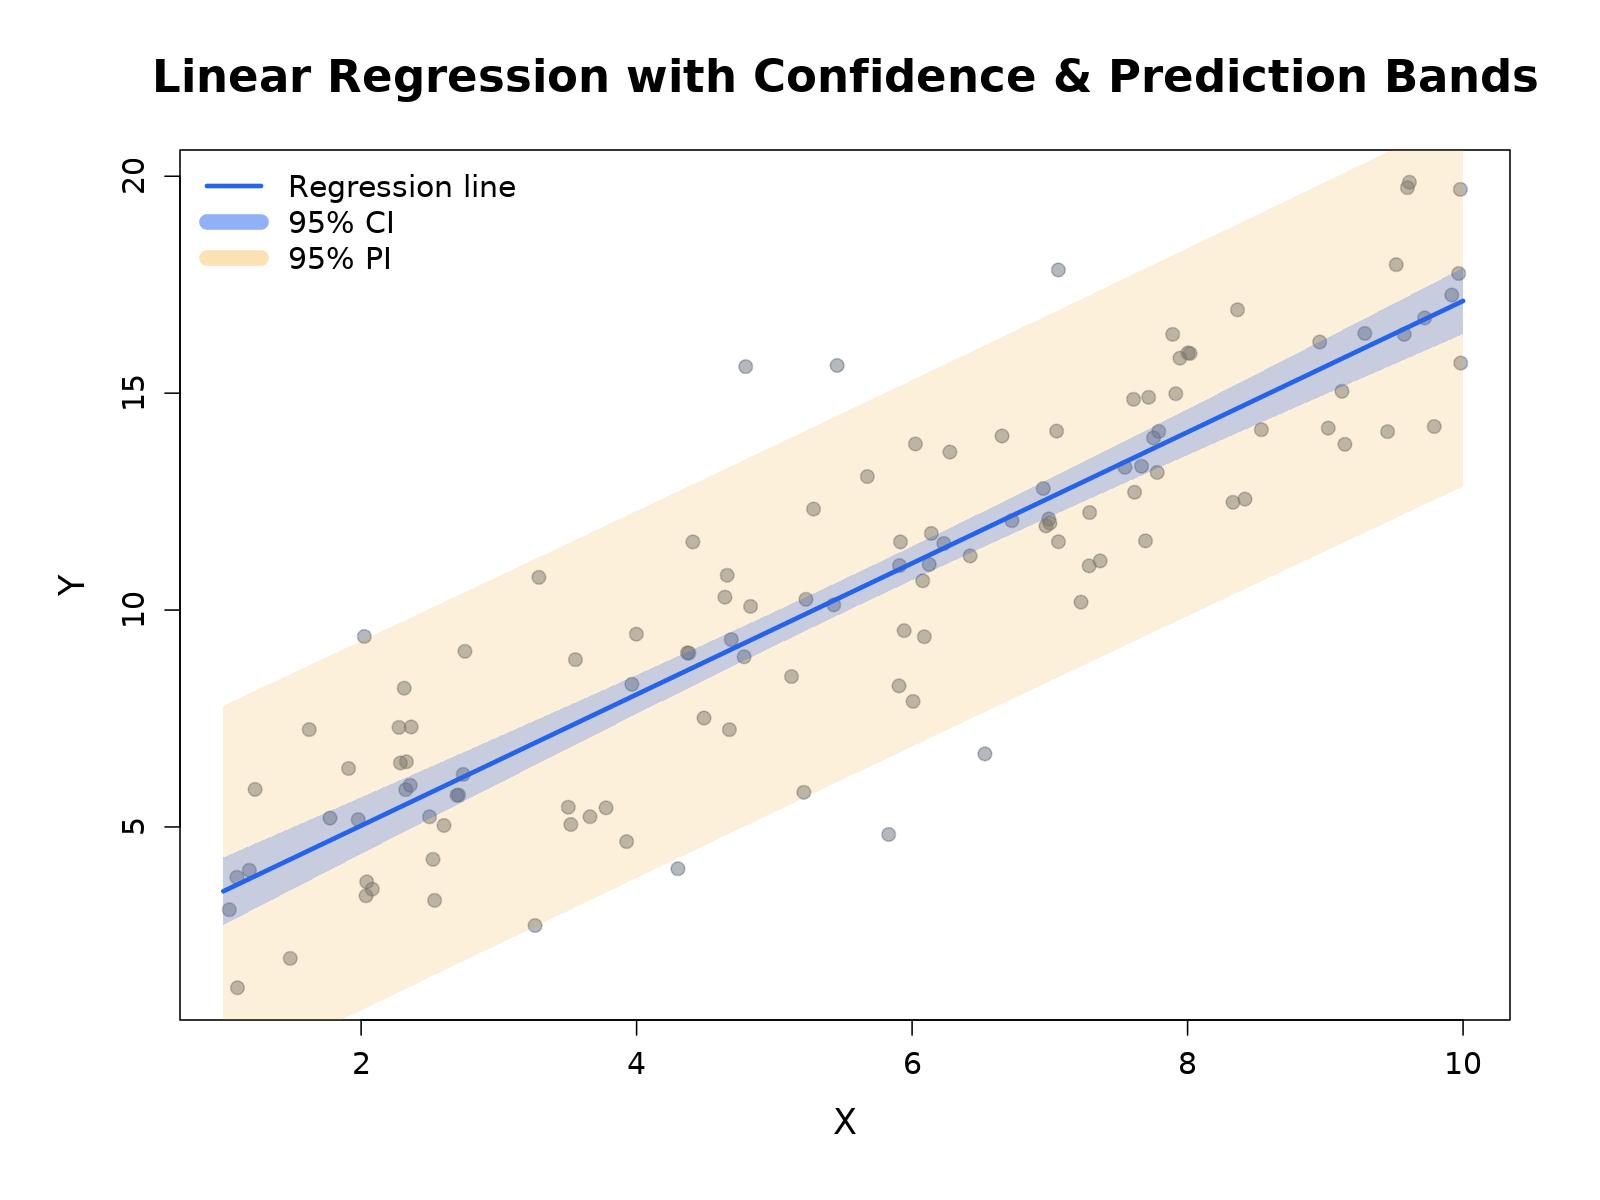
Así, la distinción entre inferencia y predicción resulta fundamental. Un modelo predictivo se evalúa por su capacidad para anticipar observaciones nuevas, el análisis inferencial también requiere valorar la incertidumbre de los parámetros, los supuestos del diseño y el alcance de las conclusiones. Ambos enfoques se complementan, pero no responden necesariamente a la misma pregunta.
El artículo «Técnicas de análisis de datos: cuáles son y para qué sirven» propone un punto de entrada para explicar que la selección de X método depende del objetivo analítico, la naturaleza de las variables y el diseño de los datos. La aportación específica de este texto consiste en mostrar cómo R permite llevar esas decisiones estadísticas a la práctica.
Análisis exploratorio y calidad de los datos
Antes de ajustar un modelo, es necesario comprender la estructura de la información. Las distribuciones, valores ausentes, registros duplicados, observaciones atípicas y las relaciones entre variables influyen en los resultados posteriores.
R facilita este trabajo mediante operaciones de filtrado, agrupación, resumen y transformación. El ecosistema tidyverse, por ejemplo, integra herramientas para manipular datos y construir representaciones gráficas coherentes. La exploración tiene como propósito identificar problemas, formular hipótesis de trabajo y decidir qué procedimientos resultan defendibles.
La detección de un valor extremo tampoco justifica eliminarlo automáticamente. Primero hay que determinar si se trata de un error de registro, una observación legítima o señal de un fenómeno relevante. El tratamiento elegido debe documentarse y justificarse.
En «¿Cómo se procesan grandes volúmenes de datos? Tecnologías y arquitecturas Big Data» se aborda el procesamiento de información a gran escala. Este artículo complementa ese enfoque al profundizar en una cuestión algo distinta: cómo evaluar estadísticamente los datos preparados antes de interpretar sus patrones.
Visualización estadística (de los resultados a la interpretación)
La visualización desempeña una función analítica. La distribución, diagrama de dispersión o una representación de series temporales ayudan a identificar patrones, heterogeneidad y posibles anomalías. También permite comunicar resultados con mayor precisión que una colección de cifras aisladas.
Entre las herramientas más conocidas se encuentra ggplot2, un sistema de visualización basado en la gramática de los gráficos. Su planteamiento separa los datos, las variables visuales, las geometrías y las escalas, esto facilita construir figuras coherentes y adaptar la presentación a diferentes necesidades (Wickham, s. f.).
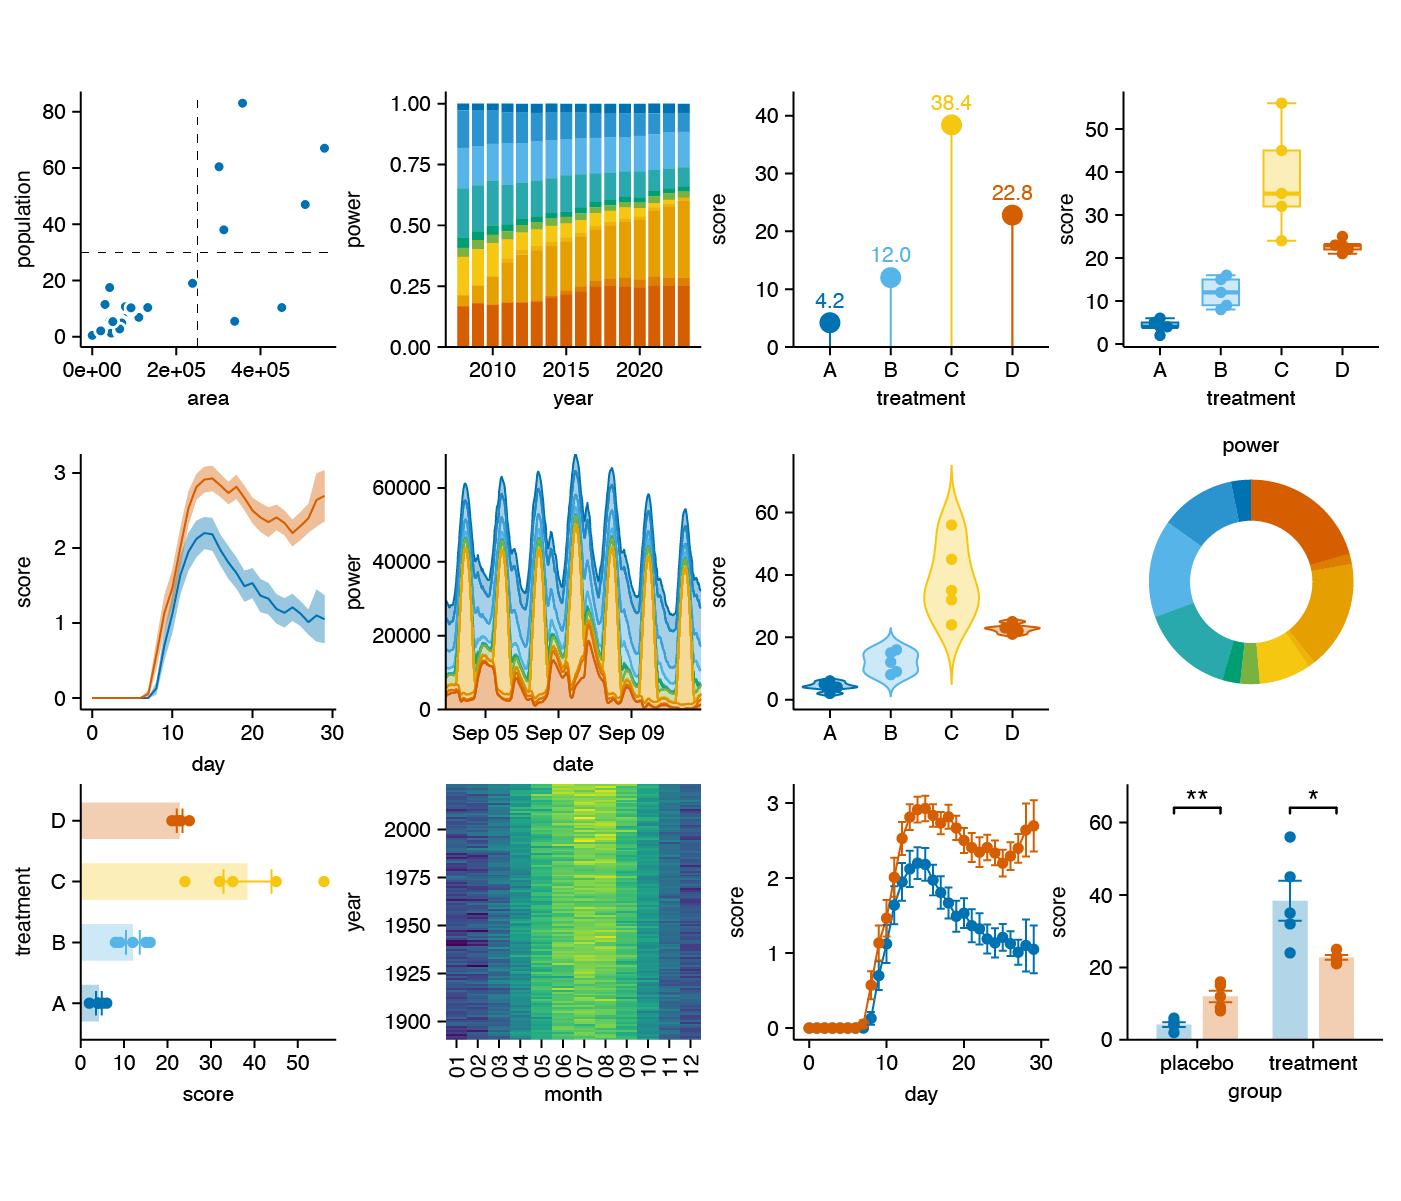
En entornos científicos y profesionales, la calidad gráfica exige decisiones explícitas (como escalas adecuadas, unidades comprensibles, leyendas informativas y representación honesta de la incertidumbre). Así que un gráfico mal diseñado distorsiona la interpretación, aunque los cálculos subyacentes sean correctos.
R también facilita la conexión entre análisis, tablas y documentos. Este enfoque resulta especialmente útil cuando los informes deben actualizarse a medida que se incorporan nuevos datos o se revisan los procedimientos.
Y, por supuesto, existe otra relación con el Máster en Big Data y Data Science de la UNED. La presencia de herramientas de análisis y visualización en este programa superior en análisis de datos permite relacionar la programación con la interpretación de resultados. En la práctica profesional, saber construir un gráfico es una parte fundamental de la competencia, pero también hay que justificar qué representa, qué información omite y qué conclusiones admite.
R y la reproducibilidad de la investigación
La reproducibilidad computacional consiste en disponer de los datos, el código y la información metodológica necesarios para volver a ejecutar un análisis y comprobar cómo se obtuvieron sus resultados (este es un rasgo central del pensamiento científico). Es un componente importante de la investigación transparente, aunque no equivale por sí solo a demostrar que una conclusión sea verdadera o que un estudio se replique con nuevos datos.
R favorece este enfoque mediante scripts, paquetes documentados y herramientas para generar informes a partir del propio código. Los documentos reproducibles permiten vincular las explicaciones, las tablas y los gráficos con los procedimientos que los producen. Quarto (del que un docente del Máster desarrollo recientemente un interesante seminario online), por ejemplo, admite bloques de código ejecutable dentro de documentos y vuelve a ejecutar esos bloques al generar el informe (Posit, s. f.).
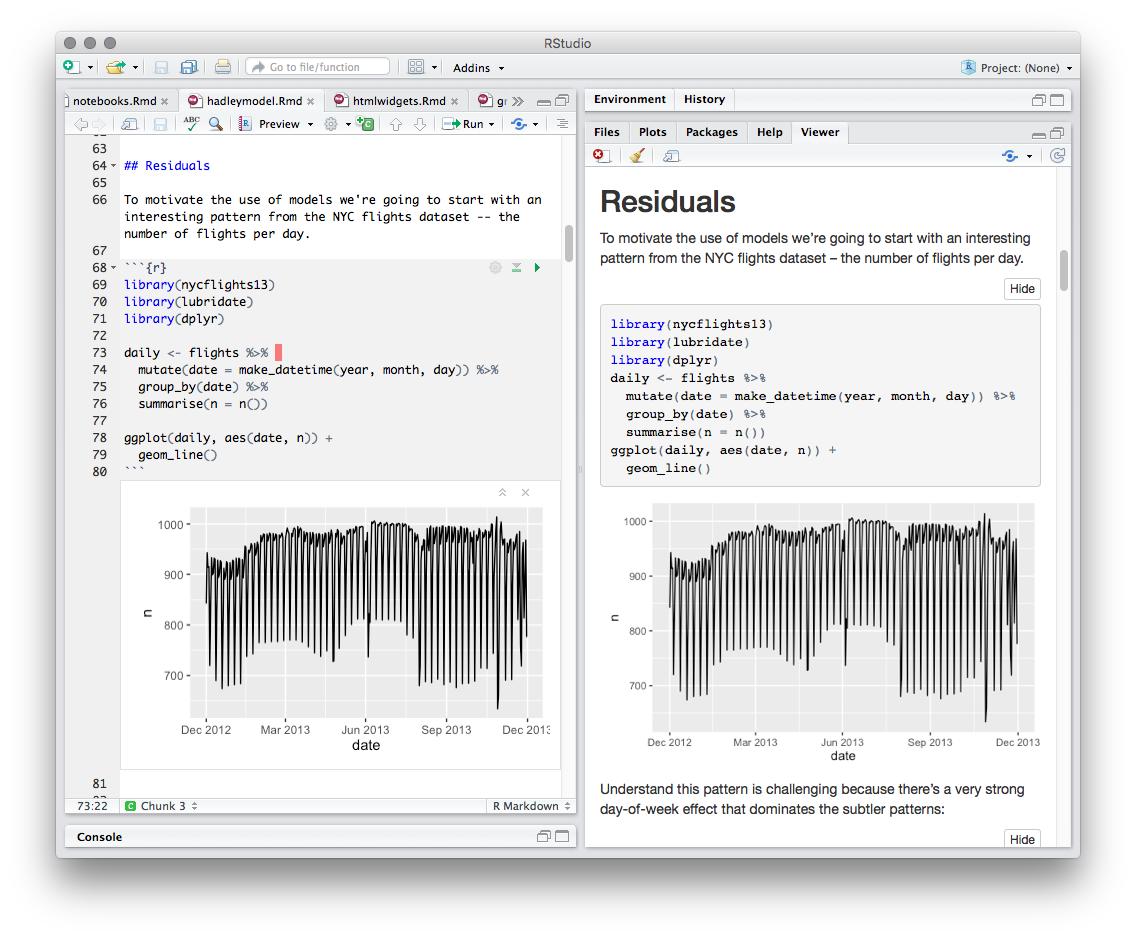
La reproducibilidad también requiere controlar las dependencias, registrar las versiones del software, conservar los datos de origen cuando sea legítimo y documentar las transformaciones. Un análisis que funciona únicamente en el ordenador del autor, sin instrucciones ni entorno definidos, resulta difícil de auditar y mantener.
Siraji y Rahman (2024) presentan prácticas para fortalecer la transparencia de los análisis en R mediante herramientas como Git, documentos dinámicos y gestión de dependencias. Este planteamiento adquiere especial importancia en investigaciones con múltiples participantes o en organizaciones donde las decisiones deben justificarse ante equipos técnicos, responsables y auditores.
El artículo «Python para análisis de datos: por dónde empezar» permite enlazar la reproducibilidad con una perspectiva más amplia de programación analítica. La comparación entre lenguajes resulta más útil cuando se centra en las prácticas de trabajo, la documentación y el mantenimiento del código, en lugar de convertirla en una competición entre herramientas.
R frente a Python tienen complementariedad, no rivalidad
La elección entre R y Python depende del problema, el equipo y la infraestructura. R destaca por su tradición estadística, la amplitud de métodos especializados y las posibilidades de visualización científica. Python ofrece un ecosistema amplio para automatización, integración con aplicaciones, aprendizaje automático y desarrollo de servicios.
Esta distinción es orientativa, pero no absoluta. Ambos lenguajes comparten capacidades y sus ecosistemas evolucionan continuamente. R también admite flujos de aprendizaje automático y despliegue. Python, por su parte, dispone de bibliotecas estadísticas y de visualización muy desarrolladas.
En una organización, la decisión debe considerar los requisitos de mantenimiento, la experiencia del equipo, la disponibilidad de bibliotecas, la integración con bases de datos y los costes de operación. En ciertos proyectos, emplear ambos lenguajes aporta ventajas; en otros, mantener una sola tecnología reduce complejidad.
El Máster en Big Data y Data Science de la UNED contempla R y Python, así como tecnologías de procesamiento de datos a gran escala. Esta combinación responde a una realidad profesional ineludible. Y es que los proyectos analíticos exigen seleccionar herramientas según su función dentro de la arquitectura, sin asumir que un único lenguaje resolverá todas las necesidades.
«Inteligencia Artificial, Big Data y Data Science: cómo se relacionan» amplía el marco conceptual de esta decisión. R debe entenderse como una pieza del proceso de ciencia de datos, integrada con la infraestructura, la preparación de información y la evaluación de modelos (en ningún caso es una solución aislada.
Límites de R en proyectos de Data Science
La especialización estadística no elimina las limitaciones técnicas. Los objetos y operaciones de R requieren una gestión cuidadosa de la memoria. Algunas tareas con conjuntos de datos muy grandes exigen optimización, procesamiento por bloques o integración con motores externos. La viabilidad depende del volumen real, la estructura de los datos y recursos disponibles (es decir, no de una cifra universal que determine cuándo deja de ser útil).
También existe una curva de aprendizaje. Es necesario comprender estructuras de datos, funciones, entornos de ejecución y gestión de paquetes, además de los conceptos estadísticos. La utilización de bibliotecas sin comprender sus propios supuestos puede producir resultados formalmente correctos desde el punto de vista computacional, pero inadecuados para la pregunta de investigación.
Por último, la apertura del software no garantiza automáticamente la calidad del análisis. La transparencia requiere código comprensible, documentación, pruebas, datos pertinentes y revisión crítica. Tampoco debe confundirse la reproducibilidad técnica con la validez científica. Como sabemos, repetir un procedimiento incorrecto solo reproduce el error.
En proyectos de Big Data, R resulta especialmente valioso cuando forma parte de una arquitectura bien diseñada, conectada con sistemas de almacenamiento y procesamiento adecuados. La decisión profesional consiste en reconocer dónde aporta mayor valor y cuándo necesita complementarse con otras tecnologías.
Conclusiones
R sigue siendo importante en Data Science porque proporciona un entorno sólido para la inferencia, modelización, exploración estadística, visualización e investigación reproducible. Su continuidad no depende de competir en todos los ámbitos con Python, sino de responder con profundidad a necesidades analíticas que siguen siendo centrales en la ciencia y en las organizaciones.
La competencia profesional exige dominar los fundamentos estadísticos, seleccionar métodos coherentes con los datos y comunicar las limitaciones de los resultados. En efecto, R aporta herramientas para ese trabajo, pero la eficacia depende del criterio de quien las utiliza y de la calidad del proceso analítico.
En una formación avanzada en Big Data y Data Science, aprender R tiene sentido cuando se integra con Python, las técnicas estadísticas, gestión de datos y evaluación de modelos. La prioridad no consiste en acumular lenguajes, sino en construir análisis fiables, interpretables y técnicamente sostenibles.
FAQ: Preguntas frecuentes sobre R para estadística
¿Para qué se utiliza R en estadística?
R se utiliza para análisis exploratorio, inferencia, regresión, contrastes de hipótesis, series temporales, métodos multivariantes y visualización, entre otras tareas.
¿R es mejor que Python para análisis estadístico?
No existe una respuesta universal. R cuenta con una tradición estadística especialmente amplia, mientras que Python ofrece un ecosistema muy versátil para integrar análisis, automatización y aplicaciones. La elección depende de los objetivos y del entorno de trabajo.
¿R sigue siendo relevante para Data Science?
Sí. Mantiene una función destacada en investigación cuantitativa, análisis estadístico y visualización. Su utilidad profesional depende del contexto y de su integración con el resto de las tecnologías del proyecto.
¿Es necesario saber estadística para trabajar con R?
Para utilizarlo con rigor en análisis de datos, resulta fundamental comprender los métodos estadísticos y supuestos de éstos. Dominar la sintaxis sin interpretar los resultados no basta para obtener conclusiones fiables.
¿R sirve para trabajar con grandes volúmenes de datos?
Sí, aunque el rendimiento depende de la arquitectura, memoria disponible y herramientas utilizadas. En determinados escenarios conviene combinar R con bases de datos, procesamiento distribuido u otros sistemas.
¿Dónde estudiar R dentro de una formación en Data Science?
El Máster en Big Data y Data Science de la UNED incluye R y Python en sus contenidos, junto con estadística, herramientas y técnicas de análisis y modelización
Referencias bibliográficas
Posit. (s. f.). Tutorial: Computations. Quarto. https://quarto.org/docs/get-started/computations/rstudio
R Core Team. (s. f.). What is R? The R Project for Statistical Computing. https://www.r-project.org/about.html
Siraji, M. A., & Rahman, M. (2024). Primer on reproducible research in R: Enhancing transparency and scientific rigor. Clocks & Sleep, 6(1), 1–10. https://doi.org/10.3390/clockssleep6010001
Universidad Nacional de Educación a Distancia. (s. f.). Contenido del Máster en Big Data y Data Science. https://www.masterbigdataonline.com/contenido.html
Wickham, H. (s. f.). ggplot2: Create elegant data visualisations using the grammar of graphics. https://ggplot2.tidyverse.org/