Introducción
Guía Data Science - Inteligencia Artificial: La inteligencia artificial ocupa un lugar prioritario en las estrategias de transformación digital. Sin embargo, entre demostrar que un modelo funciona en un entorno controlado y conseguir que opere de manera estable dentro de alguna organización existe una distancia considerable. Numerosos proyectos alcanzan una prueba de concepto, generan resultados prometedores, pero no llegan a producción. Una de las causas principales se encuentra en un elemento menos visible que los algoritmos: los datos.
Disponer de grandes volúmenes de información no significa contar con datos preparados para IA. Los sistemas necesitan acceder a información pertinente, interpretable, actualizada, trazable y protegida. También deben comprender qué significan las variables, cómo se relacionan las entidades y bajo qué condiciones se ha generado cada registro. Evidentemente, cuando estos elementos no están resueltos, el modelo puede funcionar correctamente durante una demostración y fracasar estrepitosamente al enfrentarse a la complejidad cotidiana de una empresa.
El debate sobre los datos preparados para IA (AI-ready data) ha evolucionado. Ya no se limita a la limpieza y disponibilidad de los conjuntos de datos, ahora incorpora la fragmentación de las fuentes, metadatos, interoperabilidad semántica y gobernanza. Ahora buscamos construir una infraestructura de información capaz de sostener aplicaciones reales, no únicamente experimentos.
El problema no es la falta de datos, sino su fragmentación
Información distribuid y conocimiento desconectado
Las organizaciones acumulan información en sistemas de gestión, plataformas comerciales, bases de datos, documentos, correos electrónicos, archivos históricos y aplicaciones departamentales. Cada entorno puede utilizar estructuras, identificadores y criterios propios. El resultado es una arquitectura fragmentada donde los datos existen, pero no siempre pueden relacionarse ni interpretarse de forma conjunta.
Imaginemos, por ejemplo, una empresa que utiliza tres sistemas para gestionar clientes, facturación y atención posventa. Una misma persona puede aparecer con identificadores diferentes, mientras que las fechas, categorías y definiciones de actividad comercial no coinciden. Un proyecto de IA que pretenda anticipar el abandono de clientes necesitará reconciliar esas fuentes antes de construir un modelo fiable.
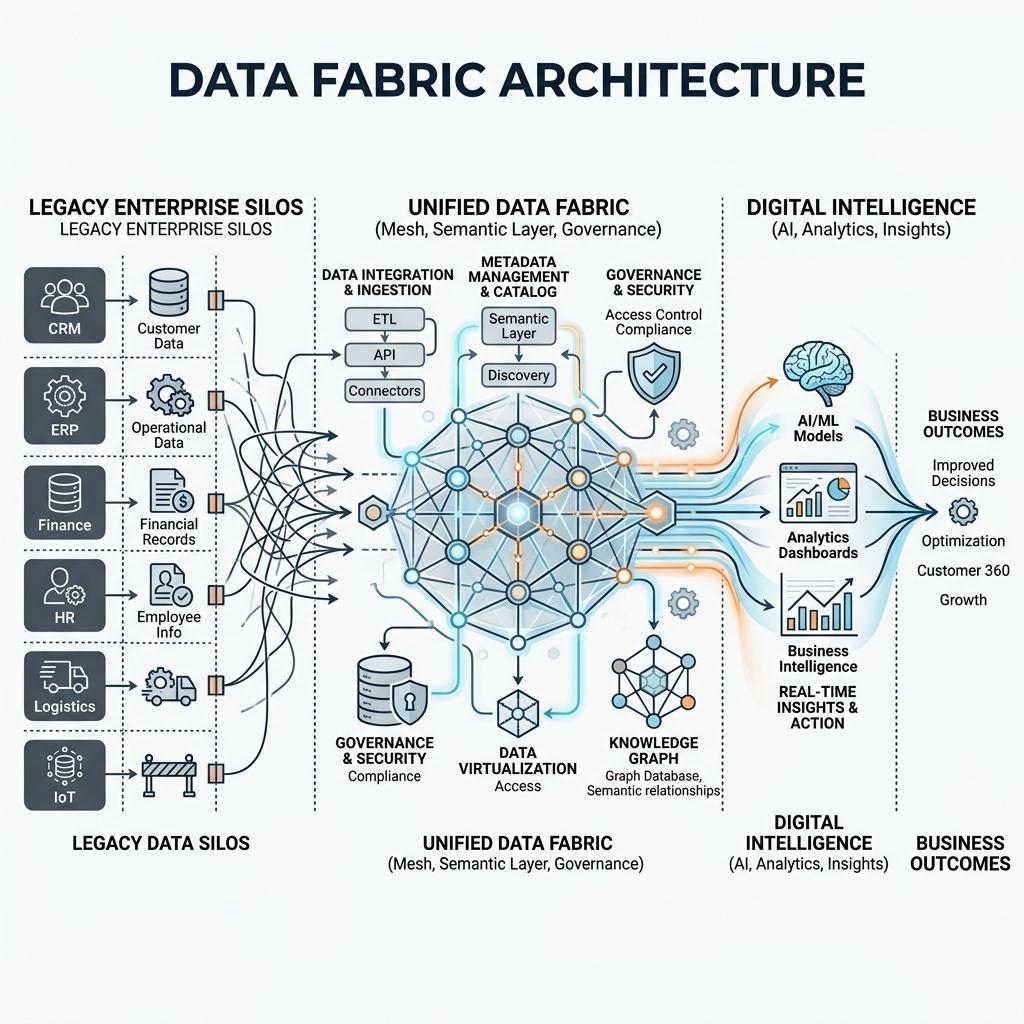
McKinsey (2026) advierte que la preparación para IA exige conectar información estructurada y no estructurada mediante una base gobernada, trazable y reutilizable. La dificultad aumenta cuando documentos, imágenes, transcripciones y otros contenidos se transforman en múltiples representaciones que deben conservar su relación con el archivo original.
En sentido de lo anterior, la fragmentación no es una simple dificultad de integración tecnológica. También constituye un problema de conocimiento organizativo (distintas áreas pueden utilizar la misma palabra para describir fenómenos diferentes o utilizar indicadores aparentemente idénticos con criterios incompatibles).
Del piloto aislado a una infraestructura reutilizable
Un piloto suele trabajar con un conjunto de datos delimitado, preparado expresamente para demostrar una funcionalidad. En producción, sin embargo, la información cambia, aparecen nuevas fuentes, se modifican los procesos y aumenta el número de usuarios. Siempre debe tenerse presente que una solución que depende de intervenciones manuales o de una integración construida para un único experimento difícilmente podrá escalar.
El piloto demuestra una posibilidad técnica. La producción exige continuidad operativa, mantenimiento, control de accesos y capacidad de adaptación. Por lo anterior, la preparación de datos debe abordarse desde el diseño del proyecto y no como una tarea puntual previa al entrenamiento.
Esta perspectiva amplía el ciclo de trabajo descrito en ¿Cómo se desarrolla un proyecto de Data Science? La preparación, evaluación y despliegue no pueden entenderse como fases independientes de la arquitectura de información que las sostiene.
Metadatos: la información que permite interpretar los datos
De describir archivos a proporcionar contexto
Los metadatos son datos que describen otros datos. Incluyen información sobre origen, formato, estructura, fecha de creación, responsable, condiciones de acceso, transformaciones y significado. Aunque tradicionalmente se han asociado a catálogos y documentación técnica, su función adquiere mayor relevancia cuando los sistemas de IA deben localizar y utilizar información procedente de múltiples entornos.
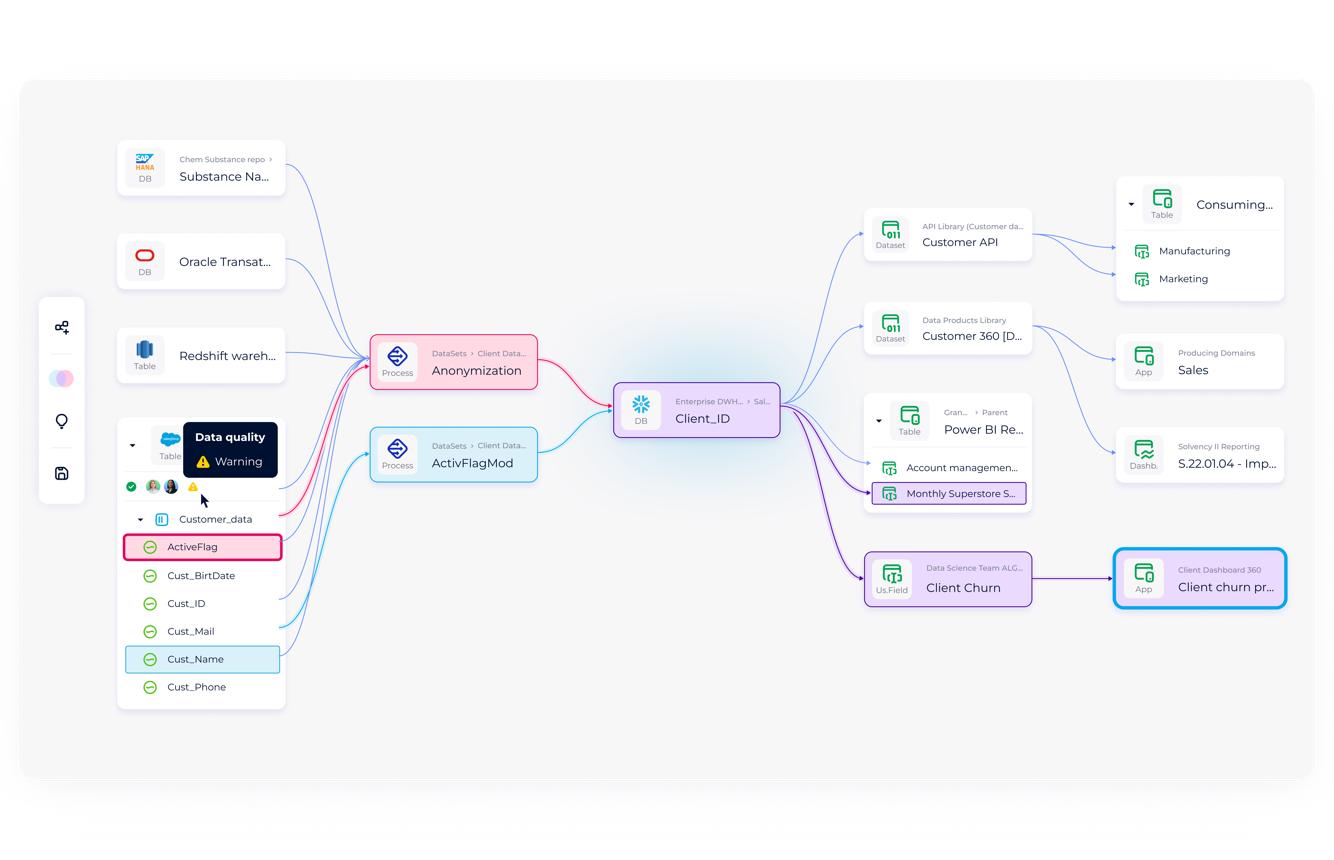
Un archivo puede contener miles de registros y, sin embargo, resultar prácticamente inútil si no se conoce qué representa cada columna, qué unidad utiliza o cuándo se actualizó. Y una variable denominada importe no informa por sí sola de si recoge valores brutos, netos, mensuales o acumulados. Sin contexto, el sistema puede procesar correctamente desde el punto de vista computacional y atribuirle un significado equivocado.
El Open Data Institute (Majithia et al., 2025) propone criterios específicos para evaluar la preparación de los conjuntos de datos, prestando atención a los datos, los metadatos y la infraestructura. Su planteamiento refleja una idea central, que la documentación es una condición para que la información resulte descubrible, interpretable y reutilizable.
Linaje y trazabilidad
Además de describir los datos, es necesario conocer su recorrido. El linaje (data lineage) permite identificar de dónde procede una información, qué operaciones ha experimentado y qué sistemas o procesos la han utilizado. Esta capacidad resulta fundamental cuando un modelo produce una predicción que debe ser explicada, auditada o corregida.
Si una organización desconoce el origen de una variable o las transformaciones que ha sufrido, difícilmente podrá determinar por qué un resultado cambia entre dos versiones del sistema. La trazabilidad conecta el dato original con sus distintas representaciones y con las decisiones que se han tomado a partir de él.
Gartner (2025) recomienda evolucionar hacia metadatos activos, capaces de contribuir a la identificación, enriquecimiento y análisis de la información. La propuesta apunta a superar los inventarios estáticos, es decir, los metadatos deben participar en la gestión cotidiana de los datos y facilitar controles automatizados.
Semántica. Cuando dos sistemas utilizan las mismas palabras con significados distintos
El problema de las definiciones incompatibles
La interoperabilidad técnica permite intercambiar información, la interoperabilidad semántica permite interpretarla de manera coherente. No son equivalentes. Por supuesto, dos bases de datos pueden conectarse mediante una API y continuar utilizando definiciones incompatibles para conceptos como cliente activo, ingreso recurrente, incidencia resuelta o riesgo elevado.
Esta diferencia tiene consecuencias directas para la IA. El sistema que combina fuentes heterogéneas necesita reconocer entidades, categorías, relaciones y reglas de negocio. De lo contrario, corremos el riesgo de agregar registros que no son comparables o responder a una consulta utilizando una definición distinta de la que espera el usuario.
Por ejemplo, si el departamento comercial considera cliente activo a quien ha realizado una compra durante los últimos doce meses, mientras que el área financiera utiliza el criterio de contrato vigente, ambos indicadores describen realidades diferentes. Así, el modelo que mezcle esas definiciones sin identificarlas generará resultados difíciles de interpretar.
Ontologías, modelos semánticos y contexto
La preparación semántica requiere establecer vocabularios compartidos, diccionarios de datos, modelos de entidades y relaciones explícitas. En ciertos proyectos, las ontologías y los grafos de conocimiento permiten representar conceptos y vínculos que no quedan reflejados en una estructura tabular convencional.
Estas herramientas adquieren especial importancia en aplicaciones basadas en recuperación aumentada por generación (RAG), donde el sistema necesita localizar documentos y fragmentos pertinentes para responder. La recuperación de información depende de la similitud entre palabras, pero también importa identificar el contexto, la entidad mencionada y la relación entre los contenidos.
La IA generativa aplicada al análisis puede facilitar consultas y transformaciones, pero necesita una base informativa comprensible. Esta cuestión complementa el enfoque del artículo IA generativa aplicada al análisis de datos: usos y posibilidades (ampliar las capacidades de interacción no resuelve automáticamente los problemas de significado y organización de la información).
Gobernanza de datos: de la responsabilidad técnica a la responsabilidad organizativa
Propiedad, acceso y calidad
La gobernanza establece quién puede utilizar los datos, quién responde por su calidad, qué reglas regulan su tratamiento y cómo se resuelven los conflictos entre áreas. Sin responsabilidades definidas, los problemas se acumulan; tendríamos conjuntos de datos sin propietario, permisos excesivos, duplicidades y criterios de calidad que cambian según el equipo.
La preparación para IA nos exige políticas sobre privacidad, seguridad, conservación, acceso, utilización legítima y gestión de información sensible. También requiere determinar quién autoriza las modificaciones y quién responde cuando una fuente deja de cumplir los requisitos establecidos.
Gartner (2025), a partir de una encuesta a responsables de gestión de datos, señaló que el 63 % de las organizaciones consultadas carecía de prácticas adecuadas para gestionar datos destinados a IA o desconocía si disponía de ellas. La consultora también advirtió del riesgo de abandonar proyectos que no cuenten con datos preparados. Estas cifras deben interpretarse como resultados de una encuesta y previsión de Gartner (no como una medición universal de todos los proyectos).
Calidad continua, no certificación puntual
La calidad de datos comprende dimensiones como exactitud, completitud, consistencia, actualidad y validez. No obstante, un conjunto de datos no es adecuado en abstracto, es decir, debe evaluarse respecto al uso previsto. La información suficiente para generar un informe descriptivo podría resultar inadecuada para entrenar un modelo que intervenga en decisiones sensibles.
El marco del Open Data Institute y los análisis recientes de McKinsey coinciden en la necesidad de evaluar la información en función de sus condiciones de utilización. La preparación busca establecer requisitos verificables, controles y umbrales de aceptación acordes con cada aplicación.
Para comprender cómo estas exigencias se relacionan con los métodos analíticos, resulta útil revisar Técnicas de análisis de datos: cuáles son y para qué sirven. La selección de una técnica depende también de la calidad, estructura y significado de la información disponible.
Cómo construir una estrategia de datos preparados para IA
Cinco líneas de actuación
Una estrategia efectiva debe comenzar por identificar los casos de uso y requisitos (no por adquirir herramientas de integración). A partir de ahí, conviene desarrollar cinco líneas de trabajo:
1-Inventariar las fuentes: Localizar datos estructurados y no estructurados, responsables, formatos, restricciones y sistemas de origen.
2-Definir estándares comunes: Establecer identificadores, diccionarios, modelos semánticos y criterios compartidos entre departamentos.
3-Implantar metadatos y linaje: Documentar el contexto, transformaciones, versiones y la procedencia de la información.
4-Establecer controles de calidad y gobernanza: Asignar responsabilidades, permisos, indicadores y mecanismos de supervisión.
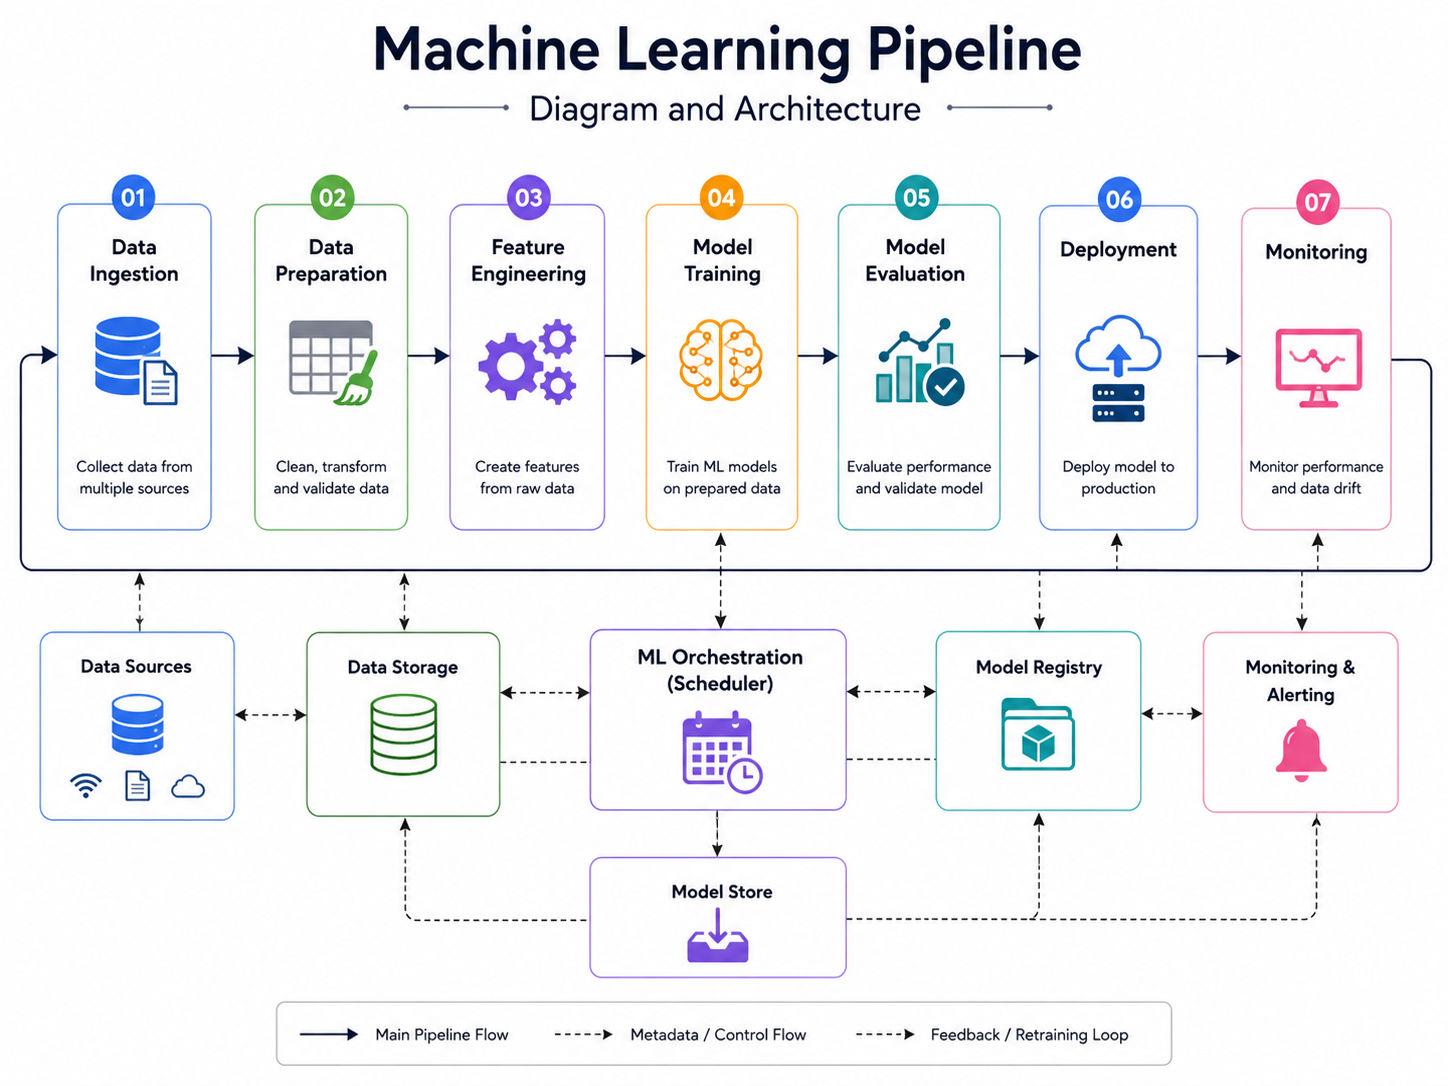
5-Diseñar pipelines reutilizables: Automatizar la ingesta, validación, transformación y actualización, con monitorización en producción.
La estrategia debe incorporar también pruebas periódicas. Los datos cambian y las condiciones que justificaron la aprobación inicial pueden dejar de cumplirse. Por lo anterior, la supervisión debe continuar después del despliegue.
Las competencias profesionales necesarias
Este trabajo requiere perfiles capaces de conectar estadística, programación, ingeniería de datos y conocimiento del negocio. El Data Scientist necesita comprender los modelos, pero también evaluar la información que los alimenta y colaborar con quienes gestionan las infraestructuras y los procesos organizativos.
El artículo ¿Qué hace un Data Scientist y qué habilidades necesita? aborda esa convergencia de competencias. Es precisamente en esta intersección donde se sitúa la formación especializada en Big Data y Data Science.
El Máster en Big Data y Data Science de la UNED forma un marco formativo relacionado con el análisis, programación, gestión de grandes volúmenes de información. Comprender la preparación de datos permite conectar esos conocimientos con un problema profesional concreto: no es otro que transformar experimentos prometedores en soluciones fiables, mantenibles y útiles para las organizaciones.
Conclusiones: la IA no escala sobre datos que la organización no comprende
El paso del piloto a producción no depende exclusivamente de mejorar el algoritmo o aumentar la capacidad de computación. Requiere resolver problemas de arquitectura, contexto, semántica y responsabilidad. Los datos preparados para IA son aquellos que pueden localizarse, interpretarse, relacionarse, gobernarse y mantenerse bajo condiciones adecuadas para cada aplicación.
La fragmentación impide construir una visión coherente, los metadatos insuficientes ocultan el origen y significado de la información, las incompatibilidades semánticas distorsionan las relaciones y una gobernanza débil dificulta controlar el acceso, la calidad y los riesgos.
La cuestión estratégica es abandonar la idea de que los datos constituyen un recurso pasivo que se entrega al modelo. Son parte de la infraestructura que hace posible la inteligencia artificial. Sin esa base, multiplicar los pilotos puede producir una apariencia de innovación sin capacidad real de transformación.
Preguntas frecuentes
¿Qué son los datos preparados para IA?
Son conjuntos de datos organizados, documentados, accesibles, contextualizados y gobernados para que puedan utilizarse de forma fiable en sistemas de inteligencia artificial. La preparación depende del objetivo y del riesgo de cada aplicación.
¿Qué diferencia existe entre datos de calidad y datos AI-ready?
La calidad evalúa características como exactitud, consistencia y completitud. La preparación para IA incorpora además contexto semántico, metadatos, trazabilidad, interoperabilidad y condiciones de acceso y utilización.
¿Por qué tantos proyectos de IA no llegan a producción?
Entre las causas figuran la fragmentación de fuentes, la dificultad para integrar sistemas, la falta de definiciones compartidas, los problemas de calidad y ausencia de responsabilidades claras sobre los datos. También influyen la seguridad, la regulación y la falta de capacidades organizativas.
¿Qué papel desempeñan los metadatos?
Permiten conocer el origen, estructura, significado, actualización y condiciones de uso de la información. Facilitan localizar los conjuntos adecuados, interpretar variables y reconstruir las operaciones realizadas.
¿Qué conocimientos se necesitan para preparar datos para IA?
Se requieren competencias en gestión y arquitectura de datos, programación, estadística, integración, calidad, metadatos y gobernanza. También es necesario comprender el contexto de negocio y las implicaciones del uso de la información.
Referencias bibliográficas
Gartner. (2025, 26 de febrero). Lack of AI-ready data puts AI projects at risk. https://www.gartner.com/en/newsroom/press-releases/2025-02-26-lack-of-ai-ready-data-puts-ai-projects-at-risk
Majithia, N., Carey-Wilson, T., & Simperl, E. (2025). A framework for AI-ready data. Open Data Institute. https://doi.org/10.61557/ODEX6433
McKinsey & Company. (2026, 23 de junio). AI data readiness: The key to scaling impact. https://www.mckinsey.com/capabilities/mckinsey-technology/our-insights/ai-data-readiness-the-key-to-scaling-impact