Introducción
Guía Data Science - Big Data: La arquitectura de datos es hoy en día una decisión estratégica para las organizaciones que necesitan integrar analítica avanzada, inteligencia artificial y explotación de grandes volúmenes de información. Durante años, el data warehouse ha constituido el entorno de referencia para consolidar datos estructurados, elaborar informes y proporcionar indicadores fiables a la dirección. Sin embargo, la expansión de los datos no estructurados, el aprendizaje automático y los sistemas distribuidos ha impulsado arquitecturas alternativas.
Entre ellas destaca el data lakehouse, un enfoque que busca combinar la flexibilidad de almacenamiento de un data lake con las capacidades de gestión, consulta y control asociadas tradicionalmente al data warehouse. Su atractivo reside en ofrecer una infraestructura común para trabajar con información heterogénea, analítica SQL y cargas de trabajo de inteligencia artificial.
En 2026 se centra en la interoperabilidad, la dependencia de proveedores, el gobierno de la información y la capacidad de reutilizar los mismos datos desde diferentes motores de procesamiento. Comprender estas diferencias resulta esencial para seleccionar una arquitectura adecuada y evitar inversiones tecnológicas que terminen reproduciendo los silos que se pretendían eliminar.
Data warehouse y data lakehouse, dos formas de organizar la información
El modelo tradicional del data warehouse
Un data warehouse es un repositorio diseñado para integrar información procedente de diferentes sistemas y ofrecer datos estructurados, consistentes y preparados para el análisis. Su arquitectura suele incorporar procesos de extracción, transformación y carga (ETL), modelos de datos definidos y mecanismos de control orientados a garantizar la coherencia de los indicadores.
Como principal fortaleza tenemos la organización. Las empresas pueden establecer definiciones comunes, construir modelos dimensionales y proporcionar información homogénea a herramientas de inteligencia de negocio. Esta estructura resulta especialmente útil para informes financieros, seguimiento de operaciones, análisis comercial y elaboración de indicadores corporativos.
Sin embargo, los modelos tradicionales pueden presentar limitaciones cuando deben incorporar información no estructurada, nuevas fuentes o cargas de trabajo que requieren procesamiento distribuido y aprendizaje automático. La adaptación de esquemas, la duplicación de información y la dependencia de determinadas plataformas también pueden incrementar la complejidad y el coste.
El enfoque lakehouse
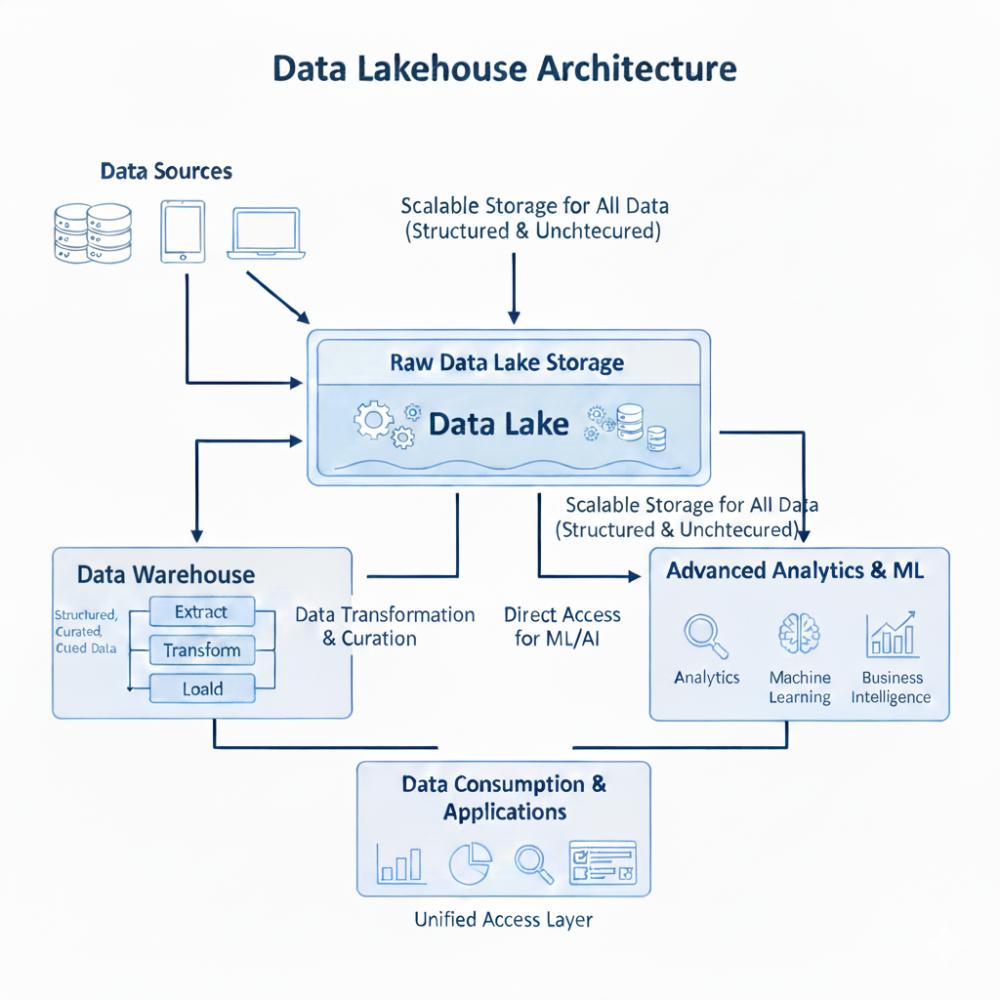
El data lakehouse intenta superar parte de estas limitaciones mediante una arquitectura que combina almacenamiento flexible, formatos abiertos y capacidades de gestión de tablas. Los datos pueden conservarse en almacenamiento distribuido, frecuentemente sobre infraestructura de objetos en la nube, mientras una capa de metadatos y gestión proporciona características propias de los sistemas analíticos.
La propuesta permite trabajar con datos estructurados, semiestructurados y no estructurados sin exigir que toda la información se transforme previamente en un modelo relacional tradicional. Pero al mismo tiempo, incorpora mecanismos para gestionar esquemas, transacciones, versiones y consultas analíticas.
Una revisión académica publicada por Mezzoudj, Khelifa y Saadna (2025) examina las diferencias entre arquitecturas de almacenamiento y sus implicaciones para el análisis Big Data. Este debate refleja que la elección depende de las necesidades de procesamiento, los formatos, escala y requisitos de cada organización.
Diferencias arquitectónicas (almacenamiento, procesamiento y gestión)
Dónde residen los datos y cómo se procesan
En un data warehouse tradicional, el almacenamiento y el procesamiento suelen estar estrechamente integrados dentro de una plataforma administrada. El proveedor controla buena parte de la organización física, la optimización de consultas y la gestión de recursos. Esta integración simplifica la operación, aunque puede limitar la flexibilidad para combinar motores o trasladar cargas de trabajo.
En un lakehouse el almacenamiento y la computación tienden a estar más desacoplados. Los datos pueden residir en sistemas de almacenamiento de objetos y ser consultados mediante distintos motores compatibles. Esta separación facilita escalar recursos de procesamiento de acuerdo con la demanda y permite que diferentes equipos utilicen la misma información para tareas distintas.
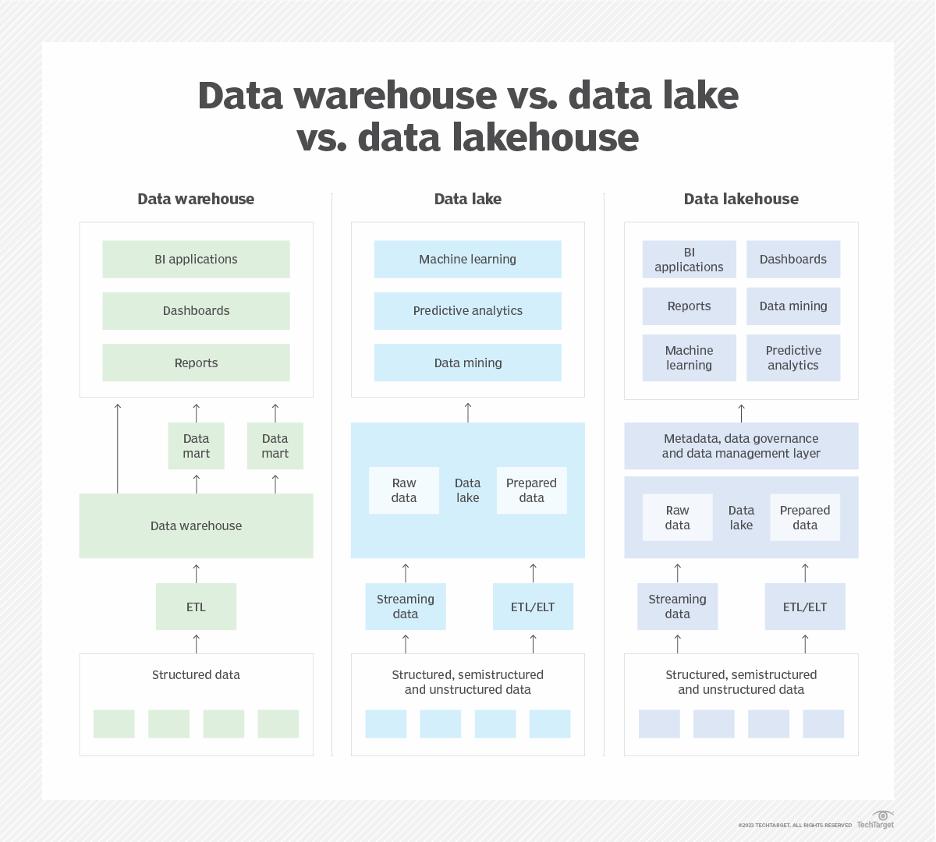
No obstante, desacoplar componentes también introduce responsabilidades. La organización debe gestionar catálogos, permisos, mantenimiento de archivos, optimización de consultas y consistencia de los metadatos. La flexibilidad arquitectónica significa distribuirla de otra manera.
Transacciones y evolución de los datos
Una dificultad histórica de los data lakes era la ausencia de garantías transaccionales comparables a las de las tablas de bases de datos. La incorporación de formatos abiertos de tablas ha modificado este escenario.
Tecnologías como Apache Iceberg, Delta Lake y Apache Hudi incorporan mecanismos para gestionar tablas sobre archivos distribuidos. Estos formatos permiten controlar versiones, registrar cambios y ofrecer operaciones más fiables que la simple lectura de archivos almacenados en directorios.
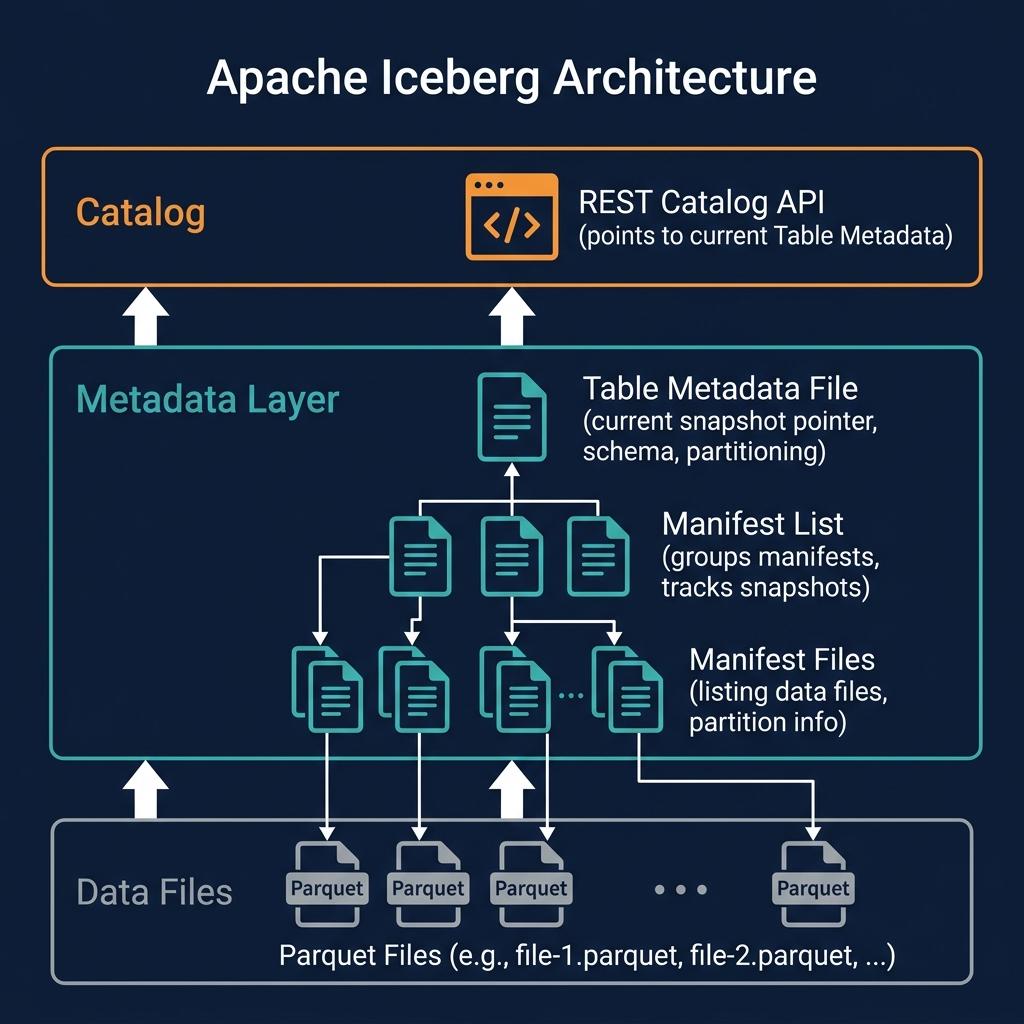
Apache Iceberg destaca por permitir evolución de esquemas y particiones, seguimiento de instantáneas y consultas sobre versiones anteriores. Su especificación define cómo se mantiene el estado de una tabla mediante metadatos y referencias a archivos de datos. Estas capacidades resultan relevantes cuando distintos procesos necesitan leer y modificar información sin perder consistencia.
Apache Iceberg es una pieza clave para la interoperabilidad
Qué aporta el formato abierto de tablas
Apache Iceberg no es un data lakehouse completo. Es un formato abierto de tablas analíticas que permite organizar archivos distribuidos como tablas gestionadas por metadatos. Esta distinción es importante, dado que una arquitectura lakehouse puede utilizar Iceberg, pero necesita también almacenamiento, catálogo, motores de procesamiento, seguridad y mecanismos de gobierno.
La especificación de Iceberg contempla archivos de datos en formatos como Parquet, Avro y ORC. Además, permite modificar el esquema sin depender exclusivamente de la posición física de las columnas y evolucionar la estrategia de particionado sin reconstruir necesariamente toda la tabla.
Otra capacidad relevante es el time travel, es decir, consultar el estado de una tabla en una instantánea anterior. Esta funcionalidad facilita reproducir análisis, investigar modificaciones y comparar resultados obtenidos con distintas versiones de los datos.
Interoperabilidad entre motores
Uno de los principales argumentos a favor de Iceberg es su orientación hacia distintos motores de procesamiento. Apache Spark, Flink, Trino, Hive e Impala figuran entre los sistemas que pueden trabajar con tablas Iceberg, aunque las capacidades concretas dependen de la versión y del nivel de implementación de cada motor.
El protocolo REST de catálogo busca facilitar todavía más esa interoperabilidad. En lugar de desarrollar una integración específica para cada catálogo, los motores pueden comunicarse mediante una API común. La documentación oficial de Apache Iceberg describe funciones como la gestión centralizada de metadatos, la resolución de conflictos y la delegación de credenciales de acceso.
La consecuencia estratégica es relevante. Los datos dejan de estar necesariamente vinculados a un único motor o interfaz. Sin embargo, utilizar un formato abierto no garantiza por sí solo independencia tecnológica. Los servicios de catálogo, las funciones avanzadas, las políticas de seguridad y optimizaciones propietarias todavía pueden generar dependencias.
Acceso a los datos (una arquitectura para diferentes cargas de trabajo)
Analítica, streaming e inteligencia artificial
El data warehouse continúa siendo una solución sólida para consultas SQL, informes empresariales y análisis sobre datos estructurados. Sus herramientas de optimización y administración simplifican el trabajo de los equipos que necesitan resultados consistentes y previsibles.
El lakehouse amplía el abanico de usos al permitir que una misma base de información sirva para analítica tradicional, procesamiento distribuido, ingeniería de datos y aprendizaje automático. Los equipos pueden utilizar datos almacenados en formatos abiertos desde diferentes entornos sin mantener necesariamente copias independientes para cada aplicación.
Esta característica resulta especialmente interesante en proyectos de inteligencia artificial. Los modelos necesitan acceder a conjuntos de datos históricos, registros recientes, documentos y otras fuentes heterogéneas. Una arquitectura que facilite la reutilización de información puede reducir duplicidades y simplificar la preparación de los datos.
Esta relación entre infraestructura y análisis se desarrolla también en el artículo ¿Cómo se procesan grandes volúmenes de datos? Tecnologías y arquitecturas Big Data, que explica por qué la elección de una arquitectura condiciona el procesamiento posterior.
El coste oculto de la flexibilidad
La posibilidad de consultar los mismos datos desde varios motores no significa que todas las operaciones tengan idéntico rendimiento. Las consultas SQL complejas, las actualizaciones frecuentes, los procesos de streaming y los entrenamientos de modelos presentan patrones de acceso diferentes.
Un lakehouse mal diseñado puede sufrir problemas de archivos pequeños, exceso de metadatos, particionado inadecuado o competencia entre procesos de lectura y escritura. La optimización exige conocer las cargas de trabajo y mantener las tablas mediante compactación, gestión de instantáneas y políticas de conservación.
Así que es necesario evaluar el comportamiento de la arquitectura bajo condiciones reales y medir latencia, concurrencia, coste de almacenamiento y consumo de computación.
¿Cuándo elegir un data warehouse y cuándo un lakehouse?
Criterios para tomar una decisión
No existe una arquitectura universalmente superior. La elección debe partir de los objetivos, las capacidades técnicas y las restricciones de la organización.
Un data warehouse suele ser adecuado cuando predominan los informes corporativos, las consultas SQL estructuradas, los indicadores regulados y la necesidad de simplificar la administración. También resulta razonable cuando la plataforma existente satisface las necesidades de rendimiento, seguridad y escalabilidad.
Un lakehouse adquiere mayor interés cuando la organización combina datos estructurados y no estructurados, necesita integrar distintos motores, desarrolla modelos de aprendizaje automático o busca reducir la duplicación de información entre plataformas.
Antes de decidir conviene valorar cinco dimensiones:
1-Diversidad de datos: formatos, fuentes y frecuencia de actualización.
2-Cargas de trabajo: informes, consultas interactivas, streaming, procesamiento distribuido y Machine Learning.
3-Interoperabilidad: compatibilidad entre motores, catálogos y formatos abiertos.
4-Gobernanza: seguridad, permisos, trazabilidad, calidad y cumplimiento normativo.
5-Coste total: almacenamiento, computación, operación, mantenimiento y dependencia de proveedores.
En ciertos escenarios, una arquitectura híbrida resulta más razonable que una migración completa. Mantener un data warehouse para algunos procesos empresariales y utilizar un lakehouse para ingeniería de datos y aprendizaje automático puede responder mejor a las necesidades existentes.
La cuestión no consiste en sustituir una tecnología por otra por razones de actualidad, sino en evitar que la arquitectura limite las posibilidades analíticas de la organización.
El papel de la arquitectura de datos en la formación especializada
La evolución de las plataformas de datos exige profesionales capaces de comprender tanto los fundamentos del almacenamiento como los procesos analíticos que se desarrollan sobre ellos. Hay que interpretar modelos de datos, evaluar alternativas de procesamiento y entender cómo las decisiones arquitectónicas afectan a la calidad y reproducibilidad de los resultados.
El artículo IA, Big Data y Data Science: ¿cómo se relacionan? permite situar estas tecnologías dentro de un ecosistema común. Big Data aporta infraestructuras y capacidad de procesamiento, Data Science proporciona métodos para extraer conocimiento y la inteligencia artificial incorpora sistemas capaces de generar predicciones, recomendaciones o contenidos.
Esta convergencia forma parte del ámbito profesional del Máster en Big Data y Data Science de la UNED, cuya formación en análisis, programación, estadística y tecnologías de datos proporciona fundamentos para comprender los desafíos de las arquitecturas contemporáneas. La capacidad de seleccionar y evaluar infraestructuras constituye una competencia relevante para quienes trabajan en proyectos de ciencia de datos.
Conclusiones: El lakehouse no elimina el problema de diseñar bien los datos
El data lakehouse representa una evolución significativa de las arquitecturas Big Data. Combina almacenamiento flexible, formatos abiertos y capacidades de gestión analítica, y facilita que diferentes motores accedan a una misma base de información. Apache Iceberg contribuye a esta evolución mediante mecanismos de transacciones, evolución de esquemas, instantáneas e interoperabilidad.
Sin embargo, no sustituye automáticamente al data warehouse. La arquitectura tradicional conserva ventajas en escenarios centrados en analítica estructurada, gobierno integrado y explotación empresarial. El lakehouse, por su parte, introduce flexibilidad, pero exige mayor atención a la operación, los metadatos y la optimización.
La decisión estratégica consiste en elegir una infraestructura coherente con las cargas de trabajo y la capacidad de gobierno de cada organización. La innovación no reside en adoptar la arquitectura más reciente, sino en construir una plataforma que permita utilizar los datos de manera eficiente, segura y sostenible.
FAQ
¿Qué es un data lakehouse?
Es una arquitectura de datos que combina la flexibilidad de almacenamiento de un data lake con capacidades de gestión, transacciones y análisis asociadas al data warehouse.
¿Qué diferencia existe entre un data lakehouse y un data warehouse?
El data warehouse suele organizar información estructurada en una plataforma analítica administrada. El lakehouse utiliza almacenamiento flexible y formatos de tablas que permiten acceder a los datos desde distintos motores y soportar cargas de trabajo más diversas.
¿Qué relación tiene Apache Iceberg con el lakehouse?
Iceberg es un formato abierto de tablas analíticas que incorpora metadatos, instantáneas, evolución de esquemas y particiones. Puede formar parte de una arquitectura lakehouse, pero no constituye por sí solo toda la plataforma.
¿Un lakehouse es mejor para inteligencia artificial?
Puede facilitar el acceso a datos heterogéneos y su reutilización en procesos de aprendizaje automático. No obstante, el rendimiento y la idoneidad dependen de la arquitectura completa, los motores, la gobernanza y las características de los modelos.
¿Es necesario abandonar un data warehouse para adoptar un lakehouse?
No. Las arquitecturas híbridas pueden ser adecuadas cuando existen procesos empresariales consolidados que funcionan correctamente y nuevas necesidades de ingeniería de datos o inteligencia artificial que requieren mayor flexibilidad.
Referencias bibliográficas
Apache Iceberg. (s. f.). Iceberg table specification. https://iceberg.apache.org/spec/
Apache Iceberg. (s. f.). REST catalog protocol. https://iceberg.apache.org/docs/latest/rest-protocol/
Apache Iceberg. (s. f.). Introduction. https://iceberg.apache.org/docs/latest/
Mezzoudj, S., Khelifa, M., & Saadna, Y. (2025). Data lakes versus data warehouses: Choosing the right approach for big data analytics. Journal of Electrical Systems and Information Technology, 12, Article 89. https://doi.org/10.1186/s43067-025-00275-0
Apache Parquet. (s. f.). Parquet file format. https://parquet.apache.org/docs/file-format/